LLM 추론 비용 절감을 위한 최적 모델 활성화 정책 연구
Optimal Model Activation Policies for Inference Networks of Large Language Models
 arXiv
LLM의 높은 추론 비용 문제를 해결하기 위해, 여러 전문가 모델을 효율적으로 조합하는 '추론 네트워크' 프레임워크가 제시되었습니다.
- 연구진은 최적 활성화 정책이 '임계값 구조'를 갖는다는 것을 증명했습니다. 즉, 저비용 모델부터 순차 사용하고 성능에 따라 고비용 모델을 호출하는 방식입니다.
- 이 방식을 적용하면 원하는 성능 수준을 유지하면서도 전체 추론 비용을 크게 절감할 수 있어 LLM의 실질적 활용도를 높일 수 있습니다.
- 특히, 작업 유형(분류/생성)별로 적절한 임계값을 계산하는 구조화된 방법이 제시되어 실제 적용 가능성을 높였습니다.
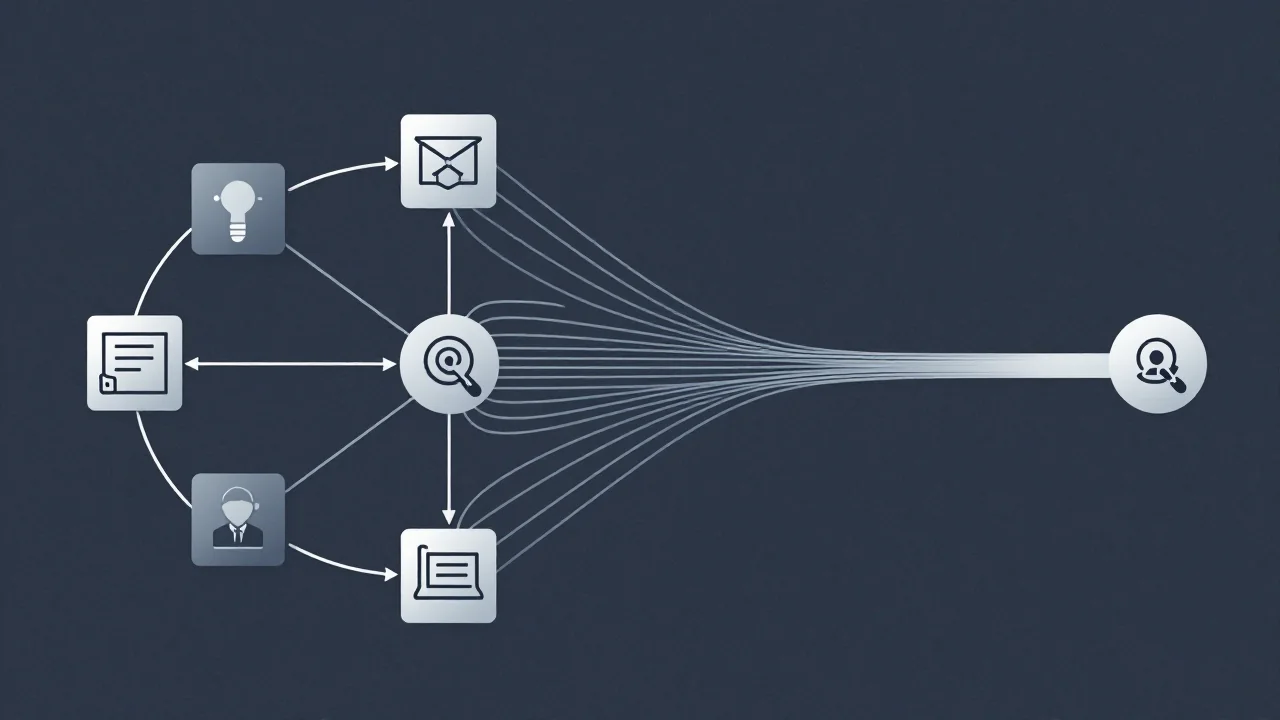
최근 (LLMs)이 자연어 처리(NLP) 작업에 필수적이 되었으나, 높은 추론 비용이 문제로 제기되고 있습니다. 이에 따라 여러 전문가 LLM을 조합하여 사용하는 방식이 시도되어 왔지만, 이를 가장 효율적으로 활용하는 원칙적인 접근법은 부족했습니다. 본 연구는 노드가 다양한 LLMs를 나타내고 링크가 조건부 모델 활성화를 의미하는 '추론 네트워크(inference networks)'라는 그래프 기반 프레임워크를 도입했습니다. 이 프레임워크의 목표는 비용-성능 트레이드오프를 가장 잘 해결할 수 있는 최적의 토폴로지를 결정하는 것입니다.
연구진은 이러한 추론 네트워크에서 모델 활성화의 최적 정책이 '임계값 구조(threshold structure)'를 갖는다는 것을 증명했습니다. 이 정책에 따르면, 먼저 가장 낮은 비용의 LLM을 질의하고, 만약 그 결과의 신뢰도가 정의된 임계값보다 낮을 경우에만 더 비싼 고성능 모델을 호출하게 됩니다. 이는 기대 추론 비용을 최소화하면서도 목표 성능 제약을 만족시키는 방식으로 작동합니다.
이러한 정책은 작업 유형에 따라 구체적인 구조를 가집니다. 판별적(discriminative) 작업의 경우 클래스마다 하나의 임계값이 필요하며, 생성적(generative) 작업의 경우에는 단일 임계값으로 구성됩니다. 연구진은 두 가지 작업 유형 모두에 대해 임계값을 계산하는 체계적인 방법과 실용적인 신뢰도 추정 메커니즘을 제시했으며, 실제 LLM 실험에서 지정된 성능 예산을 충족하면서 상당한 비용 절감을 보여주었습니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 오픈 소스
- 소스 코드를 공개해 누구나 보고 고치고 다시 배포할 수 있게 한 소프트웨어.