능동적 관측을 통한 객체 지리 위치 파악 기술 개발
Towards Active Cross-View Object Geo-Localization
 arXiv
기존의 객체 지리 위치 파악(CVOGL)이 고정된 이미지에 의존했던 한계를 극복하고, 이동 에이전트가 능동적으로 시점을 선택해 정보를 수집하는 방식을 제안했습니다.
- 연구진은 관측 효율성과 정확도를 동시에 최적화한 ActiveMoPT 프레임워크를 개발하여, 평균 1.45개의 적은 시점만으로 최고 성능(SOTA)을 달성했습니다.
- 이 기술은 로봇이나 자율 에이전트가 최소한의 관측 노력으로도 높은 정확도의 위치 정보를 얻게 하여 실제 환경 적용 가능성을 크게 높일 전망입니다.
- 제안된 방법론은 복잡한 정책 개선 과정을 거쳐 성능을 입증했으며, 858개 장면을 포함하는 대규모 제로샷 테스트 세트에서 우수함을 보였습니다.
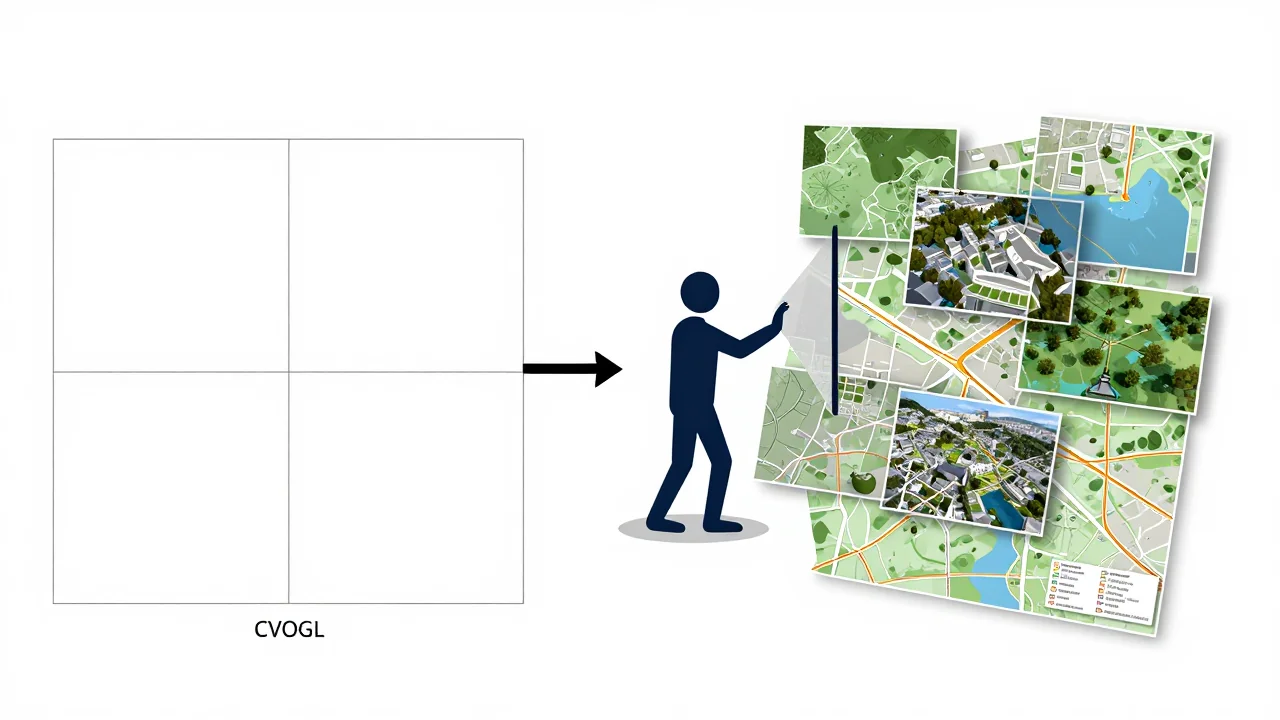
기존의 교차 뷰 객체 지리 위치 파악(CVOGL) 방식은 고정된 단일 쿼리 이미지에 의존하는 한계가 있었습니다. 이를 해결하기 위해 연구진은 능동적 교차 뷰 객체 지리 위치 파악(ActiveGeo)을 도입했습니다. ActiveGeo는 가 새로운 시점을 순차적으로 선택하고 언제 관측을 중단할지 결정함으로써, 최소한의 관측만으로도 위치 정보를 개선하는 것을 목표로 합니다.
제안된 프레임워크인 ActiveMoPT는 세 단계의 훈련 과정을 거칩니다. 첫째, Multi-View -Preserving Adaptation은 초기 프롬프트를 재사용하며 여러 개의 쿼리 뷰를 통합할 수 있게 합니다. 둘째, Trajectory-Guided Policy Initialization은 지도 학습된 에이전트 궤적을 활용하여 시점 선택과 초기 중지 행동을 학습합니다. 마지막으로, Cost-Aware Policy Refinement는 GRPO와 게인-비용 보상을 사용하여 위치 정확도와 관측 효율성을 동시에 최적화합니다.
연구진은 ActiveGeo-858이라는 테스트 세트를 구축하여 성능을 검증했습니다. 이 세트는 총 858개의 장면과 1,716개의 타겟 주석으로 구성되어 있습니다. 실험 결과에 따르면, ActiveMoPT는 평균 단 1.45개의 쿼리 뷰만 사용했음에도 불구하고 MoP-UAV에서 최고 수준의 성능()을 달성했으며, ActiveGeo-858에서의 제로샷 평가에서 기존 CVOGL 접근 방식보다 우수함을 입증했습니다.
용어 풀이
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- Prompt
- AI에게 주는 지시나 질문 글.
- 제로샷
- 예시를 하나도 주지 않고 바로 과제를 시키는 방식.
- SOTA
- State of the Art의 줄임말. 해당 분야에서 현재 가장 좋은 성능을 뜻해요.