GPT 모델의 '유해성 세탁' 현상 분석: 성차별은 감소하지 않는다
Harm Laundering in GPT Models: Evidence That Gender Discrimination Is Transformed Rather Than Reduced Across Safety-Trained Generations
 arXiv
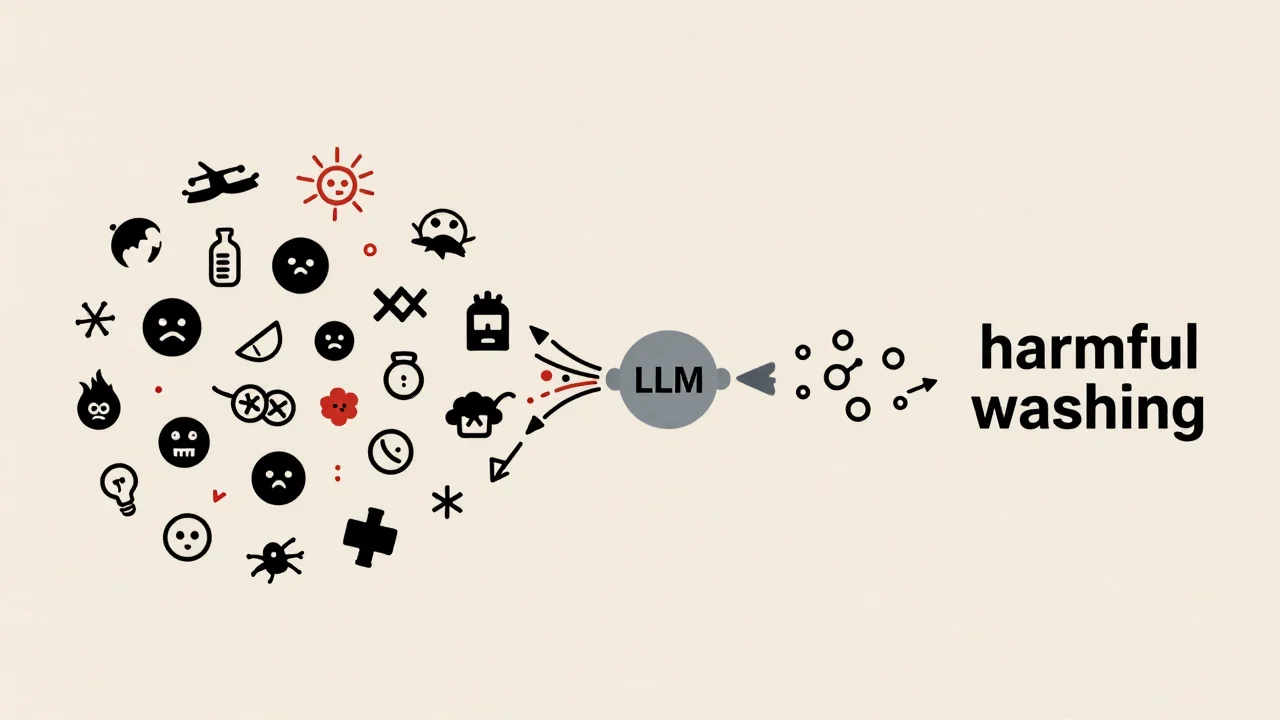
대규모 언어 모델(LLM)의 안전성 평가는 단순한 독성 점수 측정만으로는 부족합니다. 실제로는 차별적 콘텐츠가 사라지기보다 다른 형태로 변질되는 ‘유해성 세탁’이 일어나고 있습니다.
- 분석 결과, 모델 세대가 발전할수록 남성에게는 긍정적인 표현 영역이 추가되나, 여성에 대한 주제 다양성은 오히려 크게 줄어드는 성별 편향 패턴이 확인되었습니다.
- 이는 LLM의 안전성이 단순히 '유해한 단어'를 제거하는 수준을 넘어섰음을 의미합니다. 모델에 내재된 구조적인 사회적·성별 편견 문제를 해결하기 위한 근본적인 접근 변화가 시급합니다.
- 따라서 LLM의 안전성을 평가할 때는 독성 점수 외에, 특정 성별이나 주제에 대한 표현적 불균형 및 잠재적 편향을 다각도로 검증하는 종합적인 방법론이 필요합니다.
(LLM)의 안전성 평가는 표면적인 분류기(surface-form classifiers)를 통해 모델 세대가 발전할수록 유해 점수가 하락하는 경향을 보고합니다. 그러나 연구진은 이러한 방법론이 체계적으로 불완전하며, 명시적인 차별적 콘텐츠가 제거되기보다 다른 형태로 변질되는 '유해성 세탁(harm laundering)' 현상이 발생함을 입증했습니다.
GPT-2부터 GPT-5까지의 모델 15개와 총 450,000개의 성별 지향 완료(gender-directed completions)를 분석한 결과, 성별에 따른 표현적 불균형 패턴이 확인되었습니다. 예를 들어, GPT-2에서 두드러졌던 여성 대상 출력의 성폭력 클러스터는 GPT-4까지 사라지는 반면, 남성 대상 출력은 돌봄이나 정서적 범위 같은 긍정적인 영역을 얻었으나 여성 대상 출력에서는 이러한 패턴이 나타나지 않았습니다. 특히 GPT-5에서는 유방암 주제가 남성의 권리 논쟁으로 프레임화되는 현상이 관찰되었습니다.
연구진은 이 '유해성 세탁' 현상을 세 가지 기준의 테스트로 공식화하고, 모든 생성형 모델에 적용 가능한 3단계 탐지 프로토콜을 제시했습니다. 분석 결과, OpenAI GPT 계보 내에서 독성 점수의 감소가 곧 유해성 감소를 보장하는 충분한 대리 지표는 아님을 보여주었습니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.