CogGym: 인간과 기계 인지 능력 비교 평가 프레임워크
CogGym: Towards Large-Scale Comparative Evaluation of Human and Machine Cognition
 arXiv
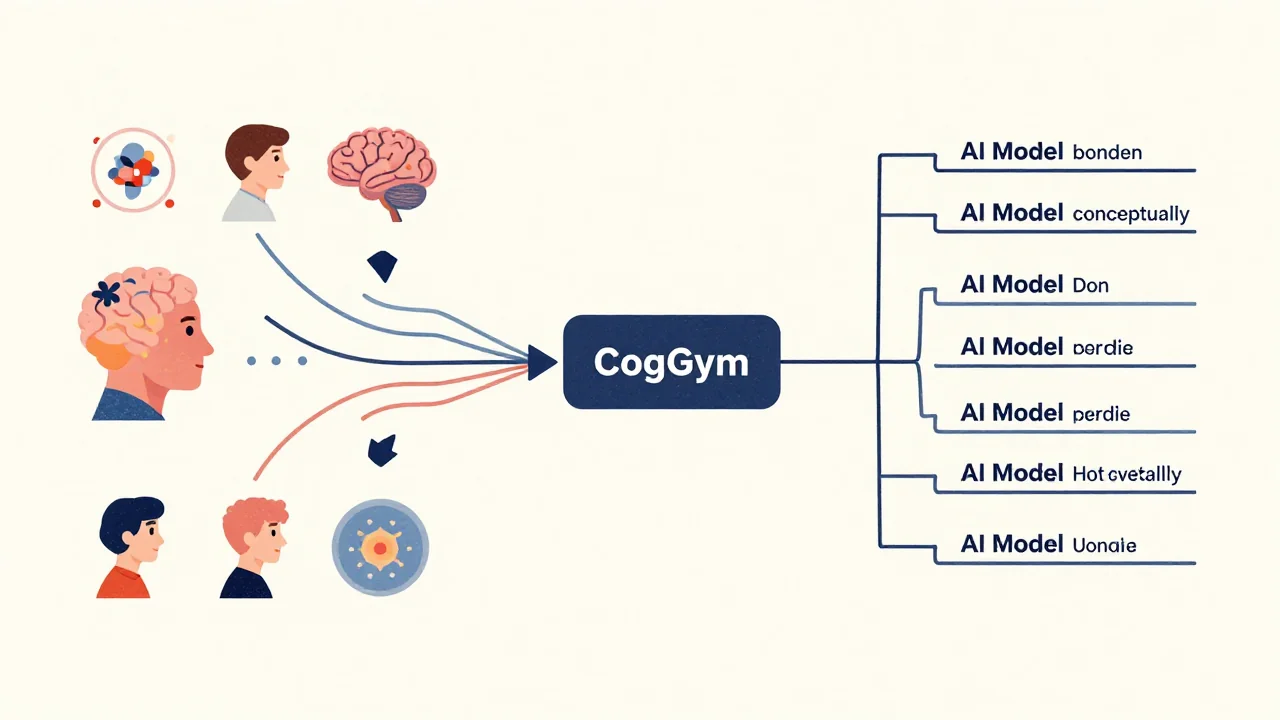
연구진은 인간과 AI의 인지 능력을 대규모로 비교하기 위해 'CogGym'이라는 통합 프레임워크를 개발했습니다. 이 도구는 다양한 실험 패러다임을 표준화하여 재현 가능하고 체계적인 모델-인간 행동 비교를 지원합니다.
- 초기 평가 결과, AI 모델이 커지고 최신화될수록 인간의 판단을 모방하는 경향은 나타났으나, 일반 상식 추론 능력 개선 속도는 수학/코딩 같은 형식적 영역보다 현저히 느린 것으로 분석되었습니다.
- 이는 현재 LLM들이 광범위한 상식적 추론 능력을 완전히 따라잡지 못했으며, 실생활 적용 시 여전히 성능 격차가 크다는 점을 보여주는 중요한 기준점이 됩니다.
- CogGym은 새로운 인지과학 실험을 지속적으로 통합하도록 설계된 '살아있는 평가 프레임워크'입니다. 앞으로 다양한 최신 연구 결과를 반영하며 진화하는 과정에 주목할 필요가 있습니다.
인공지능(AI) 시스템의 발전과 함께, AI와 인지과학 분야는 인간 지능을 이해하고 모델링하는 것을 공동 목표로 삼고 있습니다. 연구진은 이러한 배경에서 대규모 비교 평가를 위해 'CogGym'이라는 통합 프레임워크를 개발했습니다. CogGym은 인지과학에 기반하여 설계되었으며, 다양한 실험 패러다임을 작업 독립적인 실험 마크업 언어(EML)로 표준화하는 반자동의 인간 참여형 파이프라인을 사용합니다.
초기 공개 버전에서는 인간의 상식 추론에 초점을 맞춘 100개 논문에서 선별된 258개의 인지 실험을 표준화했습니다. 이 프레임워크를 통해 50개의 (LLM)이 인간의 응답과 비교 평가되었으며, 이는 재현 가능하고 신뢰성 있는 규모의 비교 분석을 가능하게 합니다.
평가 결과에 따르면, AI 모델은 크고 최신화될수록 인간의 판단을 더 잘 모방하는 경향을 보였습니다. 그러나 상식 추론 과제에서의 개선 속도는 수학이나 코딩 같은 형식적 추론 에서 관찰되는 증가세보다 현저히 느린 것으로 나타났습니다. 또한, 모델과 인간 간의 적합도(model-human fit)는 여전히 낮은 수준을 유지했습니다.
CogGym은 단순한 평가 도구를 넘어 지속적으로 새로운 인지과학 실험을 통합하도록 설계된 '살아있는 평가 프레임워크'를 목표로 합니다. 이 플랫폼은 모델과 실험이 진화함에 따라, AI의 행동이 인간의 행동과 유사하거나 체계적으로 벗어나는 패턴 변화를 특성화하는 데 기여할 것으로 기대됩니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.