LLM 기반 인간 행동 시뮬레이션의 신뢰성 분석
Understanding Reliability in LLM-based Human Behavior Simulation
 arXiv
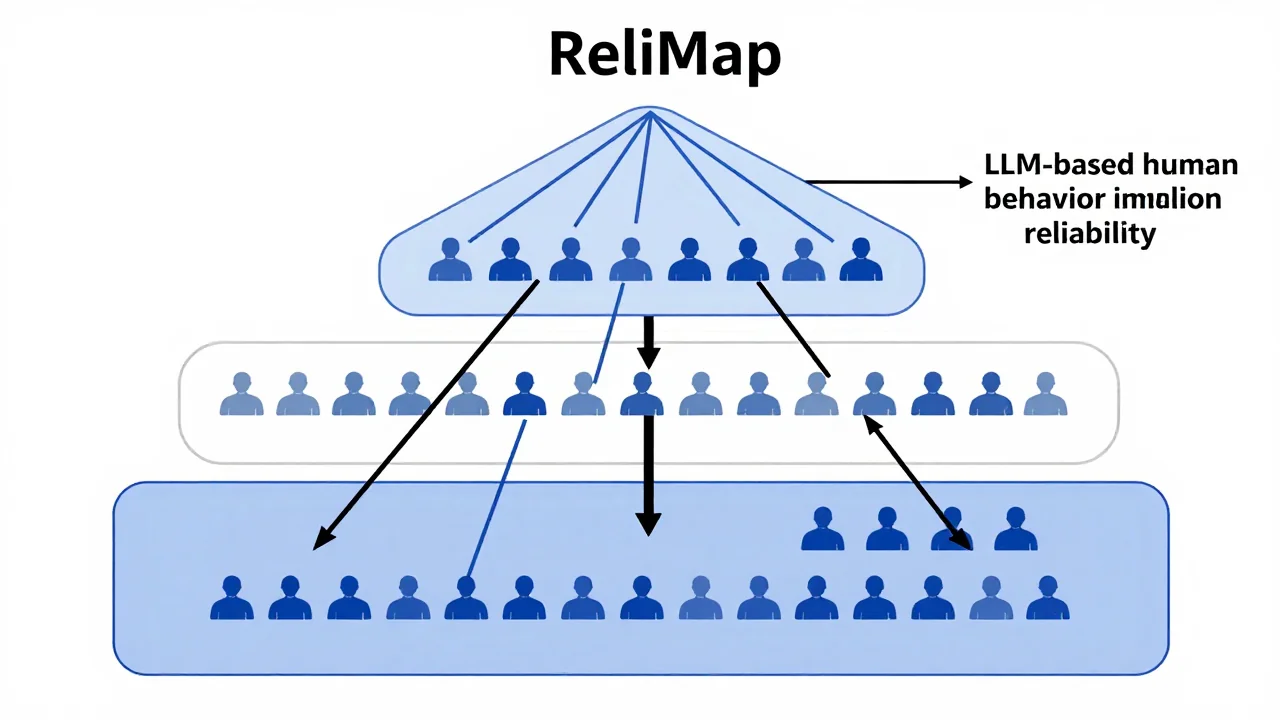
LLM 기반 인간 행동 시뮬레이션의 신뢰성을 분석하기 위해, 연구진은 과정을 세 가지 구조적 계층으로 분해하고 개별 및 집단 수준에서 신뢰도를 평가하는 'ReliMap' 방법을 제안했습니다.
- 가장 중요한 발견은 개별 사용자 수준(R1)의 신뢰성 개선이 반드시 전체 집단 수준(R2)의 신뢰성 향상으로 이어지지 않는다는 점입니다.
- 따라서 사회과학 분야에서 LLM 시뮬레이션을 활용할 때는 모델 성능이나 데이터 양에만 의존하지 않고, 시스템 전반을 종합적으로 고려한 구조적 접근이 필수적입니다.
- 신뢰성을 확보하려면 세 가지 요소(모델 역량, 프로필 정보, 집단 커버리지)가 독립적으로 아닌, 상호 연계하여 동시에 개선되어야 합니다.
(LLMs)이 인간 설문 응답 및 행동 반응을 시뮬레이션하는 데 점점 더 많이 사용되고 있지만, 신뢰할 수 없는 시뮬레이션은 사회과학적 결론을 오도할 위험이 있습니다. 기존의 평가는 주로 종단 간 점수에 초점을 맞추었으나, 연구진은 ReliMap이라는 방법을 제안하여 LLM 기반 인간 행동 시뮬레이션을 세 가지 구조적 계층으로 분해했습니다. 이를 통해 모델 역량, 프로필 정보 완성도, 인구 커버리지라는 세 차원에서 개별 수준(R1)과 집단 수준(R2) 모두에서 신뢰도를 평가할 수 있습니다.
실험 결과에 따르면, 모든 모델은 프로필 조건화가 없을 때 상당한 분포 편향을 보였습니다. 프로필 조건화를 통해 이 편향이 감소하는 것으로 나타났으나 그 효과는 점차 줄어드는 경향을 보입니다. 또한, 더 큰 규모의 모델일수록 이점을 크게 얻었으며, 단순히 정보의 양(quantity)보다는 정보의 유용성(informativeness)이 더 중요하게 작용했습니다.
가장 중요한 발견은 개별 수준(R1)에서 신뢰도를 높인 개선이 반드시 집단 수준(R2)의 신뢰도 향상으로 이어지지 않는다는 점입니다. 따라서 신뢰할 수 있는 시뮬레이션을 확보하기 위해서는 단일 계층만을 최적화하는 것이 아니라, 세 가지 요소 전반에 걸쳐 조정되고 통합적인 개선이 필수적임을 강조합니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.