리서치 연구
검색 증거 기반 QA 시스템의 답변 수정 전략 연구
Return or Revise? Learning When Revision Helps Retrieval-Augmented QA
 arXiv
검색 증거 기반 QA 시스템에서 기존 초안을 유지할지, 아니면 수정할지를 결정하는 '답변 수정(revision)' 전략의 효과를 분석했습니다.
세 줄 요약
- 단순히 초안 자체의 정확도만 보는 것이 아니라, 초안과 수정을 비교한 '쌍별 효과'를 학습한 모델이 성능 향상에 크게 기여했습니다.
- 이는 AI가 단순히 답변을 내놓는 것을 넘어, 상황별로 수정의 필요성을 판단하여 신뢰도가 높은 최종 결과물을 도출할 수 있음을 의미합니다.
- 다만, 이 방법은 여전히 일부 '해로운 수정'을 적용할 위험이 있으며, 때로는 초안이나 다른 대안 선택이 더 효과적일 수 있다는 한계도 존재합니다.
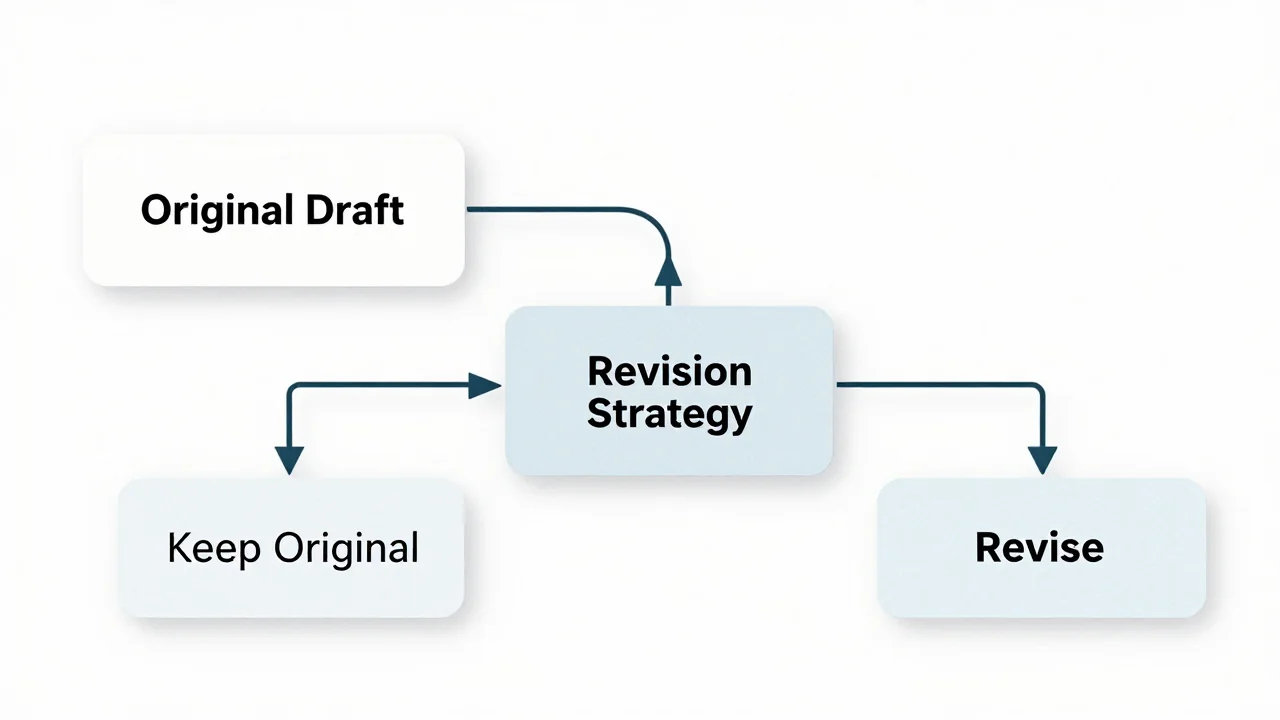
본 연구는 검색 증거를 활용하는 답변 수정(revision) 시스템에서 기존 초안 답변을 그대로 유지할지, 아니면 수정을 거칠지를 결정하는 과정을 다룹니다. 단순히 현재 답변의 신뢰도를 추정하는 것을 넘어, 지정된 수정이 미치는 효과 자체를 예측하는 것이 핵심입니다. 연구진은 이러한 쌍별 효과를 '복구 가능성(recoverability)'이라 정의하고, 이를 예측하도록 정책을 학습시켰습니다.
25,870개의 오픈 도메인 질문에 대한 실험 결과, 쌍별 결과를 학습한 스코어러는 초안의 정확도만으로 평가하는 방식보다 우수한 성능을 보였습니다. 개발 단계에서 선택된 임계값 기준으로 평균 0.23~0.68의 정확도 점수 향상을 얻었으며, 이러한 차이는 특히 밀집 검색(dense retrieval) 환경에서 유의미했습니다.
이러한 정책은 항상 수정하는 전략보다 개선되었으나, 여전히 전체 수정 중 38~46%에 해당하는 '해로운 수정'을 적용할 위험성이 남아있습니다. 또한, 초안과 후보 수정을 비교하여 선택하는 것이 더 강력하지만, 세 번째 옵션으로 후보 수정을 추가한다고 해서 유의미한 성능 향상은 관찰되지 않았습니다.