다중 카메라 기반 물고기 무리 추적을 위한 자가 지도 학습 프레임워크
TrackFish3D: Self-Supervised 3D Tracking of Schooling Fish from Multi-view Videos
 arXiv
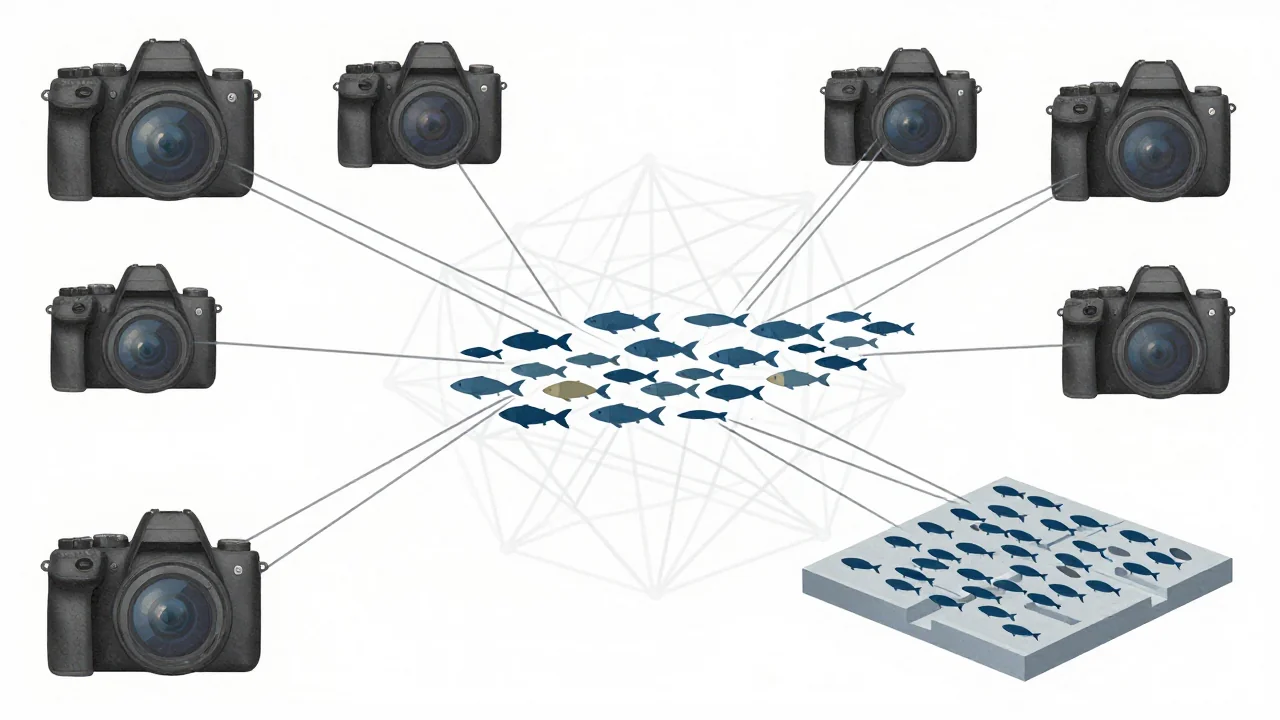
다중 카메라 영상에서 무리 지어 다니는 물고기의 3차원 움직임을 추적하는 'TrackFish3D'라는 자가 지도 학습 프레임워크를 개발했습니다.
이 기술은 물고기뿐만 아니라 새와 같은 다른 동물 무리 추적에도 적용할 수 있으며, 복잡한 3D 데이터를 직접 라벨링하지 않아도 높은 정확도를 유지한다는 점이 중요해요.
- 이 모델은 외형 정보나 수동 라벨링 대신, 카메라의 기하학적 일관성(삼각 측량)을 활용하여 객체 간 연관성을 파악하는 것이 핵심입니다.
- 기존 방식 대비 추적 정확도를 크게 높였을 뿐만 아니라, 물고기 외 새와 같은 다른 동물의 실제 영상에도 성공적으로 적용 가능함을 입증했습니다.
- 교차 뷰 라벨링이나 3D 정답 데이터가 필요 없어, 단 한 번의 학습만으로도 미지의 환경에 즉시 적용할 수 있는 실용성이 가장 큰 강점입니다.
본 연구는 다중 카메라 영상에서 무리 지어 다니는 물고기의 3차원 움직임을 정확하게 추적하는 'TrackFish3D'라는 자가 지도 학습 프레임워크를 제시합니다. 기존의 다중 뷰 3D 추적은 빈번한 가림 현상, 시각적으로 유사한 개체들, 그리고 신원(identity) 주석 데이터 부족 등의 어려움이 있었습니다. TrackFish3D는 이러한 문제를 해결하기 위해 기하학 기반의 자가 지도 학습 방식을 채택했습니다.
TrackFish3D는 외형 정보나 수동으로 지정된 신원에 의존하는 대신, 보정된 다중 뷰 기하학을 활용하여 연관성을 파악합니다. 삼각 측량 및 재투영 일관성이 가짜 연관성(pseudo-associations)을 제공하며, 모델은 기하학적 인코더와 전역 연관성 를 통해 프레임 내 모든 뷰 간의 교차 대응 관계를 학습합니다. 또한, 자가 지도 대비 목적 함수를 도입하여 공존하는 개체들을 공간에서 분리하고, 시간 예측기를 이용해 가림 현상 동안 신원을 유지하며 프레임을 연결합니다.
이 모델은 라벨링되지 않은 영상으로 단 한 번 학습하면 되며, 교차 뷰의 신원 레이블이나 3D 정답 데이터가 필요 없습니다. 성능 평가 결과, TrackFish3D는 기존 최고 성능 기준선 대비 3D 다중 객체 추적 정확도를 87.7%에서 95.8%로 향상시켰습니다. 특히 3D-ZeF 제브라피쉬 에서는 81.1%의 MOTA를 달성했으며, 이는 기존 최고 기하학 기반 기준선(77.4%)보다 높은 수치입니다. 또한 물고기 외 새 추적과 같은 실제 환경에서도 강력한 일반화 성능을 입증했습니다.
용어 풀이
- 트랜스포머
- 오늘날 대부분의 언어 모델이 쓰는 신경망 구조. 문장 속 단어들의 관계를 한꺼번에 계산해요.
- 임베딩
- 글이나 이미지의 의미를 숫자 목록으로 바꾼 것. 의미가 비슷한 것을 찾을 때 써요.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.
물고기 개체의 신원을 어떻게 파악하나요?
외형 정보나 수동 라벨링에 의존하지 않고, 보정된 다중 뷰 기하학을 활용하여 개체 간의 연관성을 파악해요. 특히 임베딩 공간에서 공존하는 개체들을 분리하고 시간 예측기를 사용해 가림 현상 중에도 신원을 유지할 수 있어요.
이 프레임워크를 사용하려면 어떤 데이터가 필요한가요?
교차 뷰의 신원 레이블이나 3D 정답 데이터가 필요하지 않아요. 라벨링되지 않은 영상으로 단 한 번 학습만 하면 되기 때문에, 미지의 환경에 즉시 적용할 수 있는 실용성이 가장 큰 장점이에요.
기존 방식과 비교했을 때 성능 향상이 큰가요?
네, 기존 최고 성능 기준선 대비 3D 다중 객체 추적 정확도가 크게 향상되었어요. 또한 물고기 외 새와 같은 다른 동물 추적에서도 강력한 일반화 성능을 입증했어요.