문맥 선택 및 목표 가중치 기반 확산 언어 모델 미세 조정
Fine-Tuning Diffusion Language Models with Context Selection and Target Weighting
 arXiv
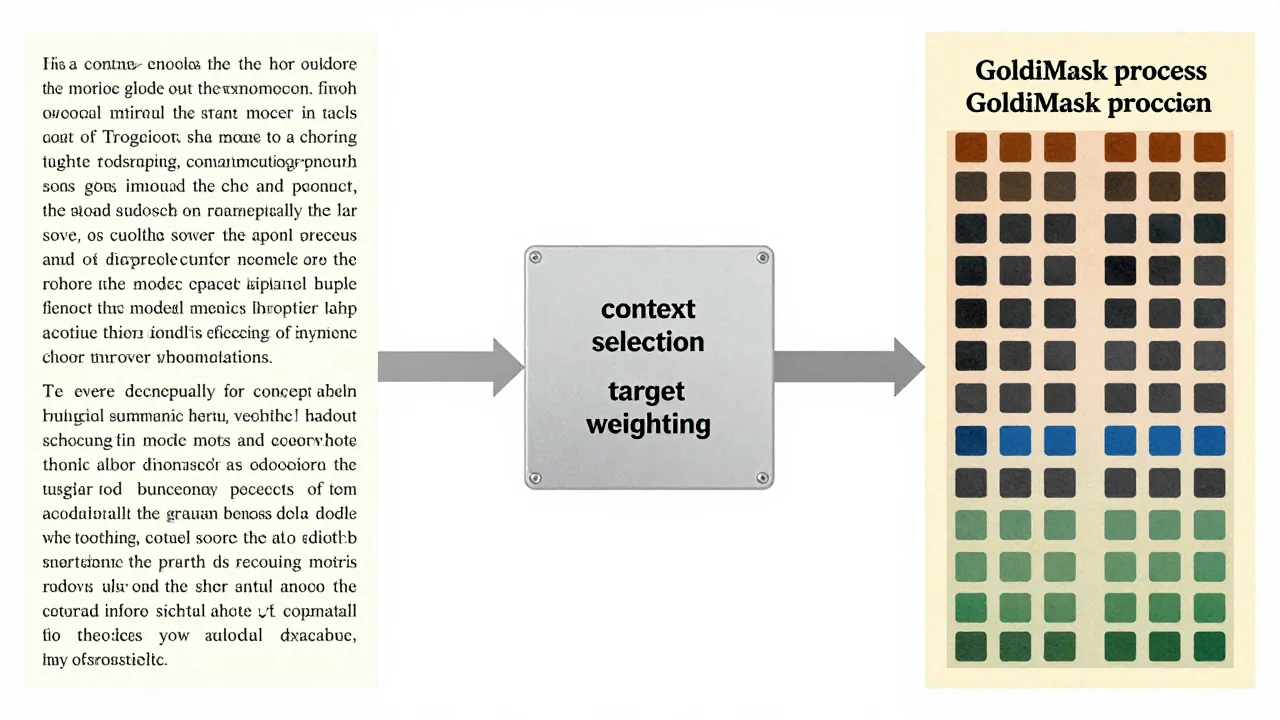
기존의 무작위 토큰 마스킹 방식의 한계를 극복한 'GoldiMask'는 문맥 선택과 목표 가중치를 결합하여 모델 학습 효율을 혁신적으로 높였습니다.
이 기술은 언어 모델 학습 시 문맥과 예측 목표를 동시에 고려하여, 추론이나 코드 생성 같은 고난도 작업에서 최고 수준의 정확도를 달성할 수 있게 해요.
- GoldiMask는 모델 신호를 활용해 문맥 노출의 이점과 예측 목표의 잠재적 가치를 동시에 고려하는 최적화 기법을 적용합니다.
- 이 기술은 추론 및 코드 생성 등 고난도 작업에서 최고 수준의 정확도를 달성하며, 언어 모델 미세 조정의 새로운 기준을 제시합니다.
- GSM8K 및 MATH-500 같은 벤치마크에서 디코딩 반복 횟수를 줄이는 효과를 보였으며, 높은 신뢰 임계값에서도 성능을 유지합니다.
이 연구는 이산형 확산 언어 모델의 지도 학습 (Supervised fine-tuning) 과정에서 발생하는 한계를 다룹니다. 기존 방식은 응답 일부를 마스킹하고, 모델이 가시적인 문맥으로부터 원래 값을 복구하도록 훈련합니다. 이때 사용되는 균일 무작위 마스킹 패턴은 모델에 제공되는 문맥과 예측 목표 간의 상호 작용을 명확히 고려하지 못하는 문제가 있었습니다.
제안된 GoldiMask는 이러한 문제를 해결하기 위해, 서브모듈 목표(submodular objective)를 근사적으로 최대화하여 문맥으로 노출할 토큰을 선택합니다. 이 최적화 과정은 모델 신호를 활용해 토큰 노출의 이점과 예측 목표로서의 가치를 동시에 균형 있게 고려합니다. 또한, 나머지 학습 목표들은 선택된 문맥으로부터 얻는 이점과 남은 학습 잠재력에 따라 개별적으로 가 부여됩니다.
세 가지 백본 모델과 세 가지 훈련 데이터셋을 대상으로 한 평가에서 GoldiMask는 대부분의 환경에서 가장 높은 평균 정확도를 달성하며, 추론 및 코드 생성 모두에서 성능 향상을 입증했습니다. 특히 GSM8K와 MATH-500 같은 에서는 신뢰도 임계값 파라렐 디코딩 시 반복 횟수를 줄이는 효과를 보였으며, 높은 신뢰도 임계값에서도 유사한 정확도를 유지했습니다.
용어 풀이
- 미세 조정
- 이미 학습된 모델을 특정 목적의 데이터로 조금 더 학습시키는 일.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- 가중치
- 학습으로 정해진 모델 내부의 숫자 값. 내려받는 모델 파일의 본체예요.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.
기존의 언어 모델 학습 방식은 어떤 한계가 있었나요?
이전에는 응답 토큰 일부를 마스킹하고 복구하도록 훈련했지만, 사용된 균일 무작위 마스킹 패턴은 모델에 제공되는 문맥과 예측 목표 간의 상호 작용을 명확히 고려하지 못하는 문제가 있었어요.
GoldiMask는 어떻게 모델 학습 효율을 높이나요?
GoldiMask는 서브모듈 목표를 근사적으로 최대화하여 문맥으로 노출할 토큰을 선택해요. 이 과정에서 모델 신호를 활용해 토큰 노출의 이점과 예측 목표로서의 가치를 동시에 균형 있게 고려하고, 나머지 학습 목표에도 개별적인 가중치를 부여합니다.
GoldiMask를 적용했을 때 어떤 성능 향상이 있었나요?
세 가지 백본 모델과 세 가지 훈련 데이터셋을 대상으로 평가한 결과, 대부분의 환경에서 가장 높은 평균 정확도를 달성했어요. 특히 GSM8K나 MATH-500 같은 벤치마크에서는 디코딩 반복 횟수를 줄이는 효과를 보였고, 높은 신뢰도 임계값에서도 유사한 정확도를 유지했습니다.