디코드 지연 피드백 프리필: 모델 비제어기 및 일반화 한계 분석
Decode-Latency Feedback Prefill: A Model-Free Controller and Its Generalization Limits
 arXiv
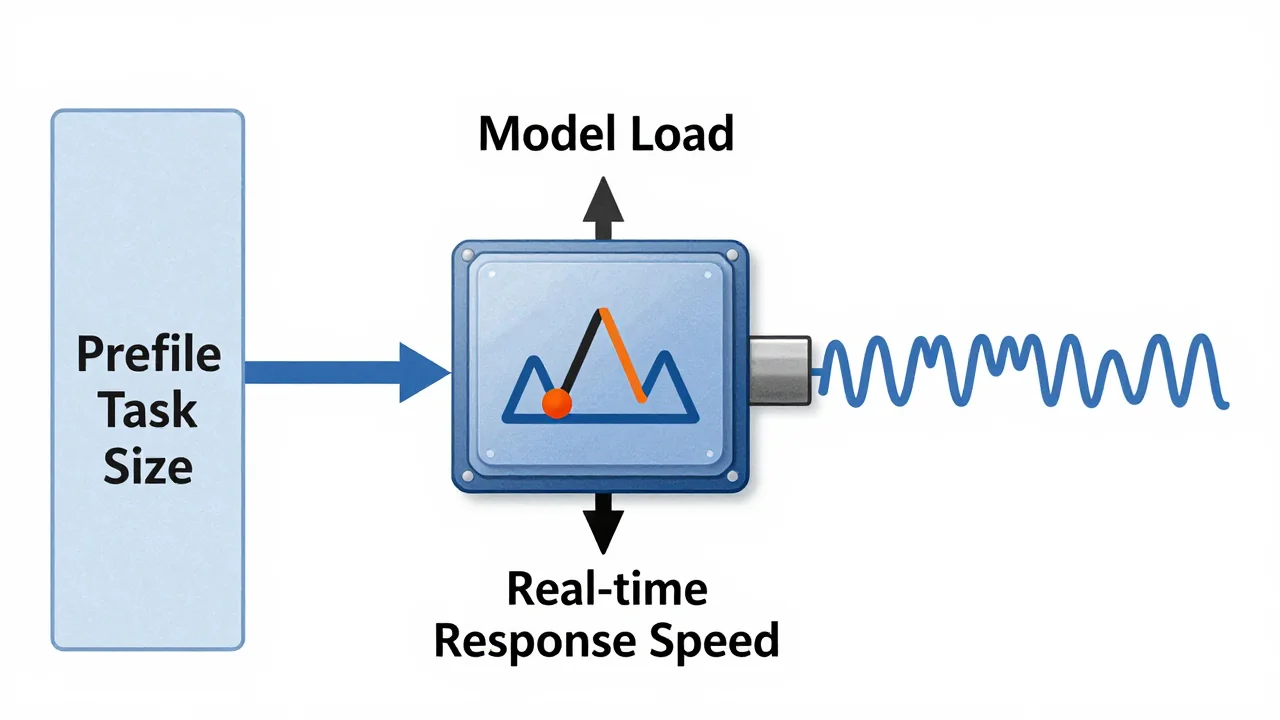
동시 추론 환경에서 발생하는 지연 문제를 해결하기 위해, 모델 부하와 실시간 응답 속도를 고려하여 프리필 작업 크기를 동적으로 조절하는 제어기 DLFP를 개발했습니다.
동시적으로 여러 사용자가 AI를 사용할 때 발생하는 지연 문제를 해결하여, 모델의 부하와 실시간 응답 속도를 최적화함으로써 사용자 경험을 크게 개선할 수 있다는 점이 중요해요.
- vLLM에 적용한 결과, P99 인터-토큰 지연 시간을 평균 27.7%까지 크게 줄이는 성능 향상을 보였으며, SLO 준수율을 유지했습니다.
- 본 연구는 LLM의 동시 처리 환경에서 발생하는 병목 현상을 개선하여 사용자 경험 저해 요소를 획기적으로 줄일 수 있음을 입증했다는 점에서 중요합니다.
- 다만, 이 제어기는 더 큰 모델이나 다중 GPU 환경에서는 성능 한계를 보였으며, 현재로서는 특정 조건에 국한된 개념 증명(PoC) 성격이 강합니다.
동시적인 자기회귀 추론 환경에서는 새로 도착한 긴 를 미리 채우는(prefilling) 작업이 이미 디코딩 중인 요청의 지연을 유발하는 근본적인 간섭 문제가 발생한다. 기존에는 고정된 프리필 청크 크기를 사용했지만, 이는 모델, 하드웨어, 부하 및 목표 지연 시간에 따라 최적화가 달라진다. 본 연구에서는 관찰된 간격을 비례 피드백으로 사용하여 다음 프리필 청크의 크기를 조정하는 모델-프리 제어기인 디코드-지연 피드백 프리필(DLFP)을 도입했다.
연구진은 DLFP를 vLLM에 구현하고 오픈 루프 포아송 도착률, 정확한 토큰 계정 등을 사용하여 평가했다. Qwen3-0.6B 모델을 A100 80 GB 에서 구동하는 테스트 결과, P99 인터-토큰 지연 시간을 평균 27.7% 감소시키는 성능 향상을 입증했다. 이 과정은 정확한 출력 일치와 SLO 준수율 유지 등의 결과를 보였다.
다만, 본 메커니즘은 Qwen3-8B나 두 개의 GPU를 사용하는 텐서 병렬 구성과 같은 더 큰 모델이나 다중 GPU 환경에서는 일반화되지 않는 한계를 보였다. 연구진은 이러한 실패 원인을 비동기 스케줄러 호출 간격이 완료된 GPU 반복 시간의 단순한 대리 지표(proxy)에 불과하기 때문으로 분석하며, 이는 향후 개선 방향을 제시한다.
용어 풀이
- 프롬프트
- AI에게 주는 지시나 질문 글.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- GPU
- 많은 계산을 한꺼번에 처리하는 칩. AI 학습과 실행에 가장 많이 써요.
LLM 추론 시 어떤 문제가 발생하나요?
동시적으로 여러 요청을 처리할 때, 새로 도착한 긴 프롬프트를 미리 채우는 작업이 이미 토큰을 생성하고 있는 다른 요청의 지연을 유발하는 간섭 문제가 근본적으로 발생해요.
성능 향상은 어느 정도였나요?
Qwen3-0.6B 모델을 테스트했을 때, P99 인터-토큰 지연 시간을 평균 27.7% 감소시키는 성능 향상을 입증했어요.
이 기술의 한계점은 무엇인가요?
더 큰 모델이나 두 개의 GPU를 사용하는 텐서 병렬 구성과 같은 다중 GPU 환경에서는 이 메커니즘이 일반화되지 않는 한계가 있어요.