CHOIR 프레임워크로 LLM 앙상블의 개별 모델 목소리 분석
Reach Into The CHOIR: Free-List Elicitation Uncovers Distinct Model Voices in LLM Ensembles
 arXiv
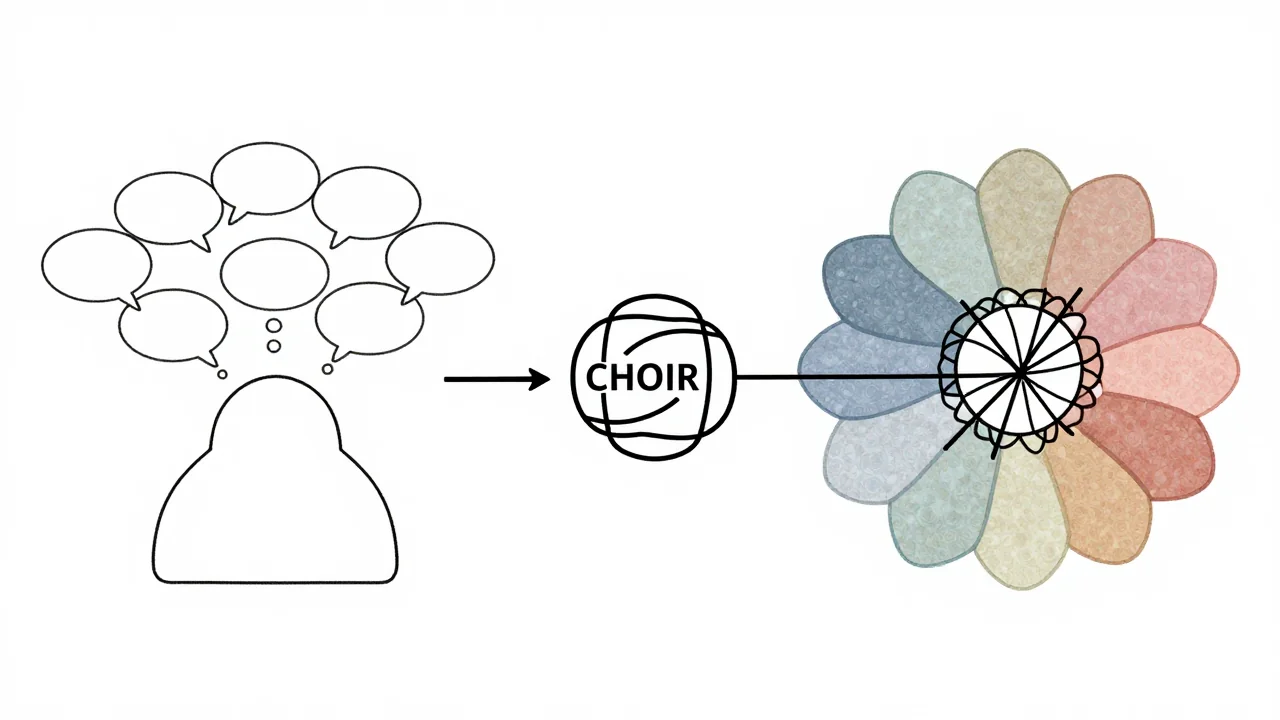
LLM 모델들이 비슷한 답변을 내놓는 '가짜 다수성' 문제를 해결하기 위해, 연구진은 CHOIR라는 새로운 분석 프레임워크를 개발했습니다.
이 프레임워크는 LLM들이 단순히 비슷한 답변을 내놓는지 여부를 넘어, 모델들이 특정 개념에서 왜 수렴하거나 다른지 깊이 있게 진단할 수 있도록 도와줘요.
- CHOIR는 단순 질문 대신 인지인류학 기반의 '순위 목록 반복 요구' 방식을 적용하여, 표면적 유사성과 모델 고유의 깊은 차이를 분리합니다.
- 이 방법론을 통해 LLM 평가가 단순히 답변 비교에 그치지 않고, 모델들이 특정 개념에서 왜 수렴하거나 이탈하는지를 진단할 수 있게 됩니다.
- 특히 기본 모델의 고유한 특성(base-model identity)을 가장 강력하게 포착하며, 안정적인 후보군 식별에 초점을 맞춘 진단적 접근이 핵심입니다.
모델들이 유사한 답변을 내놓는 '가짜 다수성' 문제를 해결하기 위해, 연구진은 CHOIR(Collective Hierarchically-Ordered Inquiry Responses)라는 프레임워크를 개발했습니다. 이 방법론은 인지인류학에서 파생된 자유 목록 추출 방식을 LLM 앙상블에 적용합니다. CHOIR는 반복적으로 순위가 매겨진 목록을 요구하고, 항목들을 수준의 개념으로 군집화하며, 모델, 프롬프트 변형, 페르소나 조건 전반에 걸쳐 개념의 현저성을 측정하는 것이 핵심입니다.
이 방법론은 개방형 질문에서의 동질성을 진단적 측정 문제로 전환합니다. 즉, 모델들이 어디에서 수렴하고, 왜 수렴하는지, 그리고 구조화된 깊이 탐색을 통해 무엇이 여전히 도달 가능한지를 분석할 수 있게 합니다. 평가 결과에 따르면, 기본 모델의 정체성(base-model identity)이 가장 강력한 복구 가능한 서명으로 나타났으며, 페르소나 프롬프트는 기본 모델 서명 내에서 표면화된 개념을 변화시키는 것으로 확인되었습니다.
CHOIR를 Infinity-Chat 100 및 목표 진단 은행에 적용하여 평가했을 때, 높은 표면적 일치성(93/100 프롬프트가 우연 확률 이상)을 재현하는 동시에, 좁은 질문과 넓은 질문의 복구 가능한 깊이를 분리할 수 있었습니다. 또한, 출처를 고려하지 않는 순위 지정 모듈은 나중에 검사하기 위해 희귀하지만 안정적인 후보군에 우선순위를 부여합니다.
용어 풀이
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 프롬프트
- AI에게 주는 지시나 질문 글.
LLM 모델들이 비슷한 답변을 내놓는다는 '가짜 다수성' 문제란 무엇인가요?
여러 LLM 모델들이 유사한 답변을 내놓으면서 실제로는 개별적인 차이가 가려지는 현상을 말해요. 이 프레임워크는 이러한 문제를 해결하기 위해 개발되었어요.
CHOIR 프레임워크가 기존 평가 방식과 다른 점은 무엇인가요?
단순한 질문 대신 인지인류학 기반의 순위 목록 반복 요구 방식을 사용해요. 이를 통해 모델들이 개념을 어떻게 군집화하고 어떤 개념이 현저하게 나타나는지를 측정할 수 있어요.
이 방법론으로 가장 강력하게 포착되는 것은 무엇인가요?
평가 결과에 따르면, 기본 모델의 고유한 정체성(base-model identity)이 가장 복구하기 쉬운 서명으로 나타났어요. 이는 모델 자체의 근본적인 특성을 보여줘요.