학습 과정 없는 합성 데이터 생성 파이프라인 GENSCRIPT
Synthesis Without Training: An Inference-Only Pipeline for Tabular, Temporal, and Relational Synthetic Data
 arXiv
학습 과정 없이 합성 데이터를 생성하는 GENSCRIPT를 제안합니다. 기존의 '모델 학습 후 샘플링' 방식이 가진 데이터 유형별, 훈련 주기적 한계를 극복한 혁신적인 파이프라인입니다.
기존 합성 데이터 생성 방식이 필요로 했던 모델 학습 과정을 완전히 제거하여, 다양한 형태의 데이터를 효율적으로 만들 수 있게 해줘요.
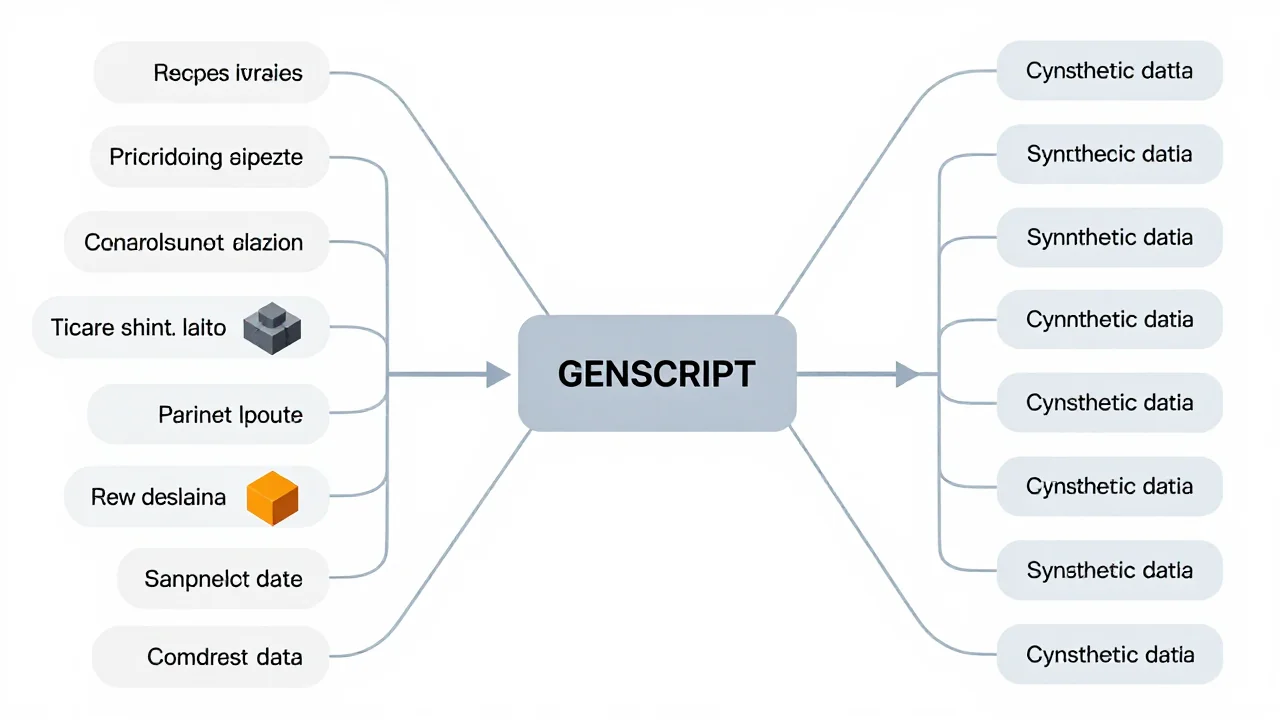
- 원본 데이터의 통계적 프로파일과 구조적 제약 조건만 추출하여 언어 모델에 전달하고, 이를 실행 가능한 샘플러로 컴파일하는 것이 핵심 작동 원리입니다.
- 단일 테이블부터 시계열, 관계형 DB까지 통합 지원하며, 특히 기본/외래 키를 완벽히 보존하거나 실제 분포와 유사한 조건부 시계열을 생성합니다.
- 데이터 학습 없이 프로파일만으로 작동하여 효율적이지만, 이 방식의 성능은 원본 데이터의 구조 및 제약 조건을 얼마나 정밀하게 추출할 수 있는지에 달려 있습니다.
기존의 생성 방식은 '모델 학습 후 샘플링' 패러다임에 의존하며, 이로 인해 모든 데이터셋마다 새로운 훈련 과정이 필요하고, 단일 테이블, 시계열, 관계형 DB 등 다양한 데이터 모달리티별로 개별 모델과 특징 공학(feature engineering)이 요구되는 한계를 가집니다. 본 연구에서는 이러한 문제를 해결하기 위해 학습 과정을 완전히 제거한 추론 전용 파이프라인인 GENSCRIPT를 제안했습니다.
GENSCRIPT는 원본 데이터의 통계적 프로파일(컬럼 유형, 범위, 결측 여부, 카테고리, 상관관계 등)을 결정론적으로 계산하여 이를 언어 모델에 전달합니다. 이 과정에서 단순히 원시 행(raw rows)이 아닌 프로파일 자체가 핵심 입력으로 사용되며, 은 이를 통해 필드 의미와 컬럼 간 무결성 제약 조건을 추론해냅니다. 이후 코딩 가 이 프로파일과 제약 조건들을 실행 가능한 감사 가능 샘플러로 컴파일합니다.
이 통합된 접근 방식은 단일 테이블, 시계열, 관계형 데이터까지 모두 지원하며, 성능 면에서도 높은 효율성을 보입니다. 네 가지 단일 테이블 에서 GENSCRIPT는 생성기를 2분 만에 구축하고 6초 이내에 50k 행을 샘플링했습니다. 특히 Adult 데이터셋의 컬럼 간 1:1 매핑을 완벽하게 보존했으며, 스마트 빌딩 데이터셋에서는 실제 분포와 더 유사한 조건부 시계열을 생성하고 기본 키 및 외래 키 관계를 완벽히 유지하는 것으로 나타났습니다.
용어 풀이
- 합성 데이터
- 실제로 모은 것이 아니라 AI나 프로그램으로 만들어 낸 학습용 데이터.
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.
GENSCRIPT는 어떤 원리로 합성 데이터를 생성하나요?
원본 데이터의 통계적 프로파일(컬럼 유형, 범위 등)을 결정론적으로 계산해서 언어 모델에 전달해요. 이 프로파일과 제약 조건을 바탕으로 코딩 에이전트가 실행 가능한 샘플러로 컴파일하는 것이 핵심 작동 방식이에요.
기존의 합성 데이터 생성 방식과 비교했을 때 어떤 장점이 있나요?
기존 방식은 모든 데이터셋마다 새로운 훈련 과정이 필요했지만, GENSCRIPT는 학습 과정을 완전히 제거한 추론 전용 파이프라인이라 효율적이에요. 원본 데이터의 프로파일만으로 작동하기 때문이에요.
어떤 종류의 복잡한 관계를 유지하며 데이터를 생성할 수 있나요?
단일 테이블, 시계열 데이터, 그리고 관계형 DB까지 모두 지원해요. 특히 기본 키와 외래 키 같은 복잡한 관계를 완벽하게 보존하거나 실제 분포와 유사한 조건부 시계열을 만들 수 있어요.