하드웨어 사양 기반 LLM 최적화 도구 llmfit 소개
AlexsJones/llmfit
 GitHub
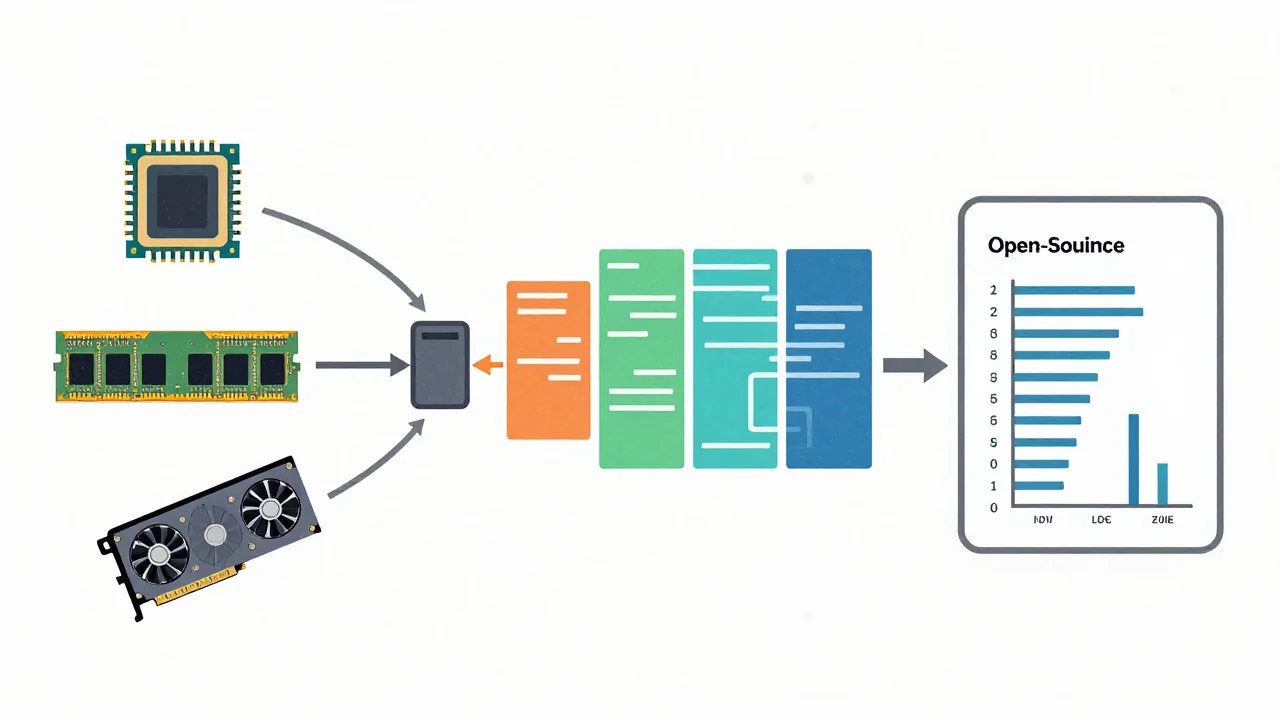
하드웨어 자원(CPU, RAM, GPU 등)을 자동으로 감지하여 현재 시스템에서 구동 가능한 오픈소스 LLM을 찾아주고 성능을 예측하는 전문 도구입니다.
- 단순한 사양 분석을 넘어, 사용자가 직접 벤치마크를 수행한 실측 데이터를 공유하며 모델 적합성 추정치를 지속적으로 개선합니다.
- 복잡한 환경 구축 시 자원 초과 위험 없이 하드웨어에 가장 최적화되고 효율적인 LLM을 선택할 수 있도록 지원합니다.
- 모델의 속도와 메모리 적합성은 사양 및 양자화 형식을 기반으로 예측되므로, 최종 성능은 실제 구동 환경에 따라 달라질 수 있습니다.
llmfit은 사용자의 하드웨어 자원(CPU, 시스템 RAM, 및 VRAM 등)을 자동으로 감지하여 현재 시스템에서 구동 가능한 (LLM)을 추천하는 터미널 도구입니다. 이 도구는 단순히 사양만 분석하는 것을 넘어, 모델의 수, 컨텍스트 길이, 그리고 , AWQ, GPTQ, EXL2와 같은 다양한 형식을 분석하여 메모리 사용량과 예상 성능을 예측합니다.
llmfit은 NVIDIA CUDA, Apple Silicon, AMD ROCm, Intel OneAPI 등 여러 아키텍처를 지원하며, Multi-GPU 환경이나 MoE(Mixture-of-Experts) 구조와 같은 복잡한 모델도 처리할 수 있습니다. 사용자는 가벼운 터미널 인터페이스(TUI)나 기능이 풍부한 웹 대시보드 중 원하는 방식으로 접근할 수 있으며, REST API 엔드포인트(`/api/v1/system`, `/api/v1/models`)를 통해 오케스트레이터나 자동화된 배포 파이프라인에 통합하는 것도 가능합니다.
사용자들은 직접 벤치마크를 수행한 실측 데이터를 프로젝트에 기여하여 모델 적합성 추정치를 지속적으로 개선할 수 있습니다. `llmfit bench --share` 명령어를 통해 하드웨어 성능 측정 결과를 공유하면, 동일한 사양을 가진 다른 사용자들에게도 실제 측정이 반영된 정확한 벤치마크 수치가 제공됩니다.
이 도구는 Docker 컨테이너 배포를 지원하며, `--tui` 플래그를 사용하여 대화형 TUI 모드로 실행할 수 있습니다. 또한 `llmfit recommend --json`과 같은 명령어를 통해 시스템 프로필 및 추천 모델 목록을 JSON 형식으로 출력하여 에이전트나 스크립트에서 쉽게 소비할 수 있도록 설계되었습니다.
용어 풀이
- GPU
- 많은 계산을 한꺼번에 처리하는 칩. AI 학습과 실행에 가장 많이 써요.
- 오픈소스
- 소스 코드를 공개해 누구나 보고 고치고 다시 배포할 수 있게 한 소프트웨어.
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 매개변수
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.
- GGUF
- 언어 모델을 개인 PC에서 돌리기 쉽게 담는 파일 형식. llama.cpp 계열 도구에서 써요.
- 양자화
- 모델 숫자의 정밀도를 낮춰 크기와 메모리 사용을 줄이는 기법. 품질이 조금 떨어질 수 있어요.