비자발적 결정 엔진 Laya: 다국어 및 장문맥 구조화 데이터 추출
NandhaKishorM/laya
 GitHub
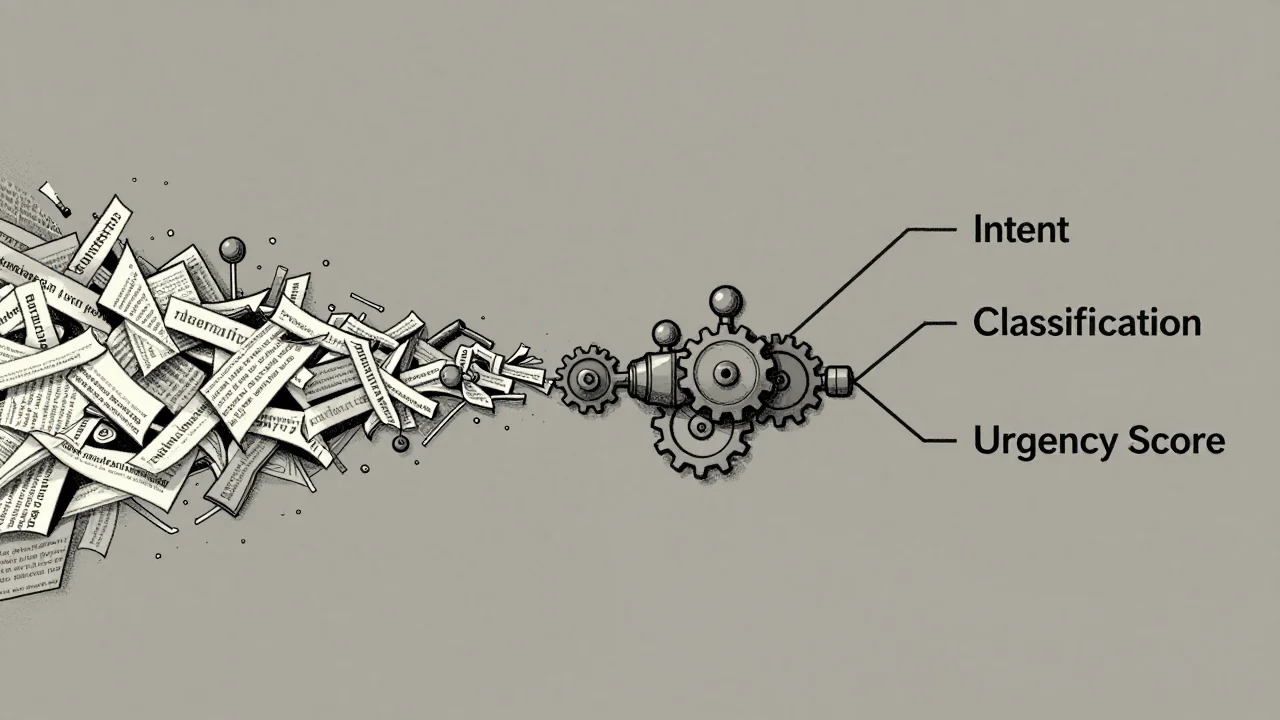
Laya는 대규모 문서나 고객 문의 등 비정형 텍스트에서 의도, 분류, 긴급도 점수 같은 구조화된 결정을 추출하는 전문 엔진입니다.
- 텍스트 생성 없이 단일 순방향 패스로 작동하며, 최대 8,192 토큰의 긴 문맥과 100개 이상의 언어를 지원하는 것이 핵심 기술적 특징입니다.
- 고객 서비스 티켓 분류나 문서 기반 정보 추출 등 특정 업무 워크플로우에서 일관되고 정확한 의사결정을 지원하여 운영 효율성을 극대화합니다.
- 기본 모델도 강력하지만, 도메인 특화된 최고 정확도를 위해서는 자체 데이터를 활용한 미세 조정(Fine-tuning) 과정이 필수적입니다.
Laya는 텍스트 생성 과정 없이 단일 순방향 패스(single forward pass)를 통해 비정형 상태(state)에서 의도, 분류, 긴급도 점수와 같은 구조화된 결정을 추출하는 다국어 엔진입니다. 이 시스템은 'choice', 'score', 'noul'과 같은 유형의 결정 질문을 처리하며, 텍스트 생성이나 파싱 과정이 없어 현상(hallucination)이 발생하지 않는 것이 특징입니다. T4 환경에서 한 가지 질문에 대해 33ms가 소요되는 등 빠른 속도를 제공합니다.
Laya는 최대 8,192 까지 처리할 수 있는 긴 문맥을 지원하며, `laya-multilingual` 모델을 통해 100개 이상의 언어에서 작동합니다. 시스템은 요청마다 적절한 체크포인트를 선택하는 라우터를 사용하여 다국어 처리를 수행합니다. 사용자는 Python 코드를 통해 상태와 질문 구조를 정의하고, `router.predict()` 함수를 호출하여 결과를 얻을 수 있으며, 이 과정은 100개 이상의 언어에서 동일하게 작동하도록 설계되었습니다.
기본 체크포인트만으로도 높은 성능을 보이지만, 특정 도메인에 최적화된 정확도를 위해서는 자체 데이터를 활용한 (Fine-tuning)이 필수적입니다. 예를 들어, typed-decisions 에서 기본 영어 체크포인트가 0.362의 정확도를 기록한 반면, 미세 조정된 `laya-typed-decisions`은 0.766의 정확도를 달성했습니다. 사용자는 이 기능을 통해 자체 워크플로우에 맞는 고도화된 의사결정 모델을 구축할 수 있습니다.
용어 풀이
- 환각
- AI가 사실이 아닌 내용을 그럴듯하게 지어내는 현상.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- 미세 조정
- 이미 학습된 모델을 특정 목적의 데이터로 조금 더 학습시키는 일.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.