벡터 DB 없이 사람이 읽듯 추론하는 RAG 엔진 PageIndex 소개
VectifyAI/PageIndex
 GitHub
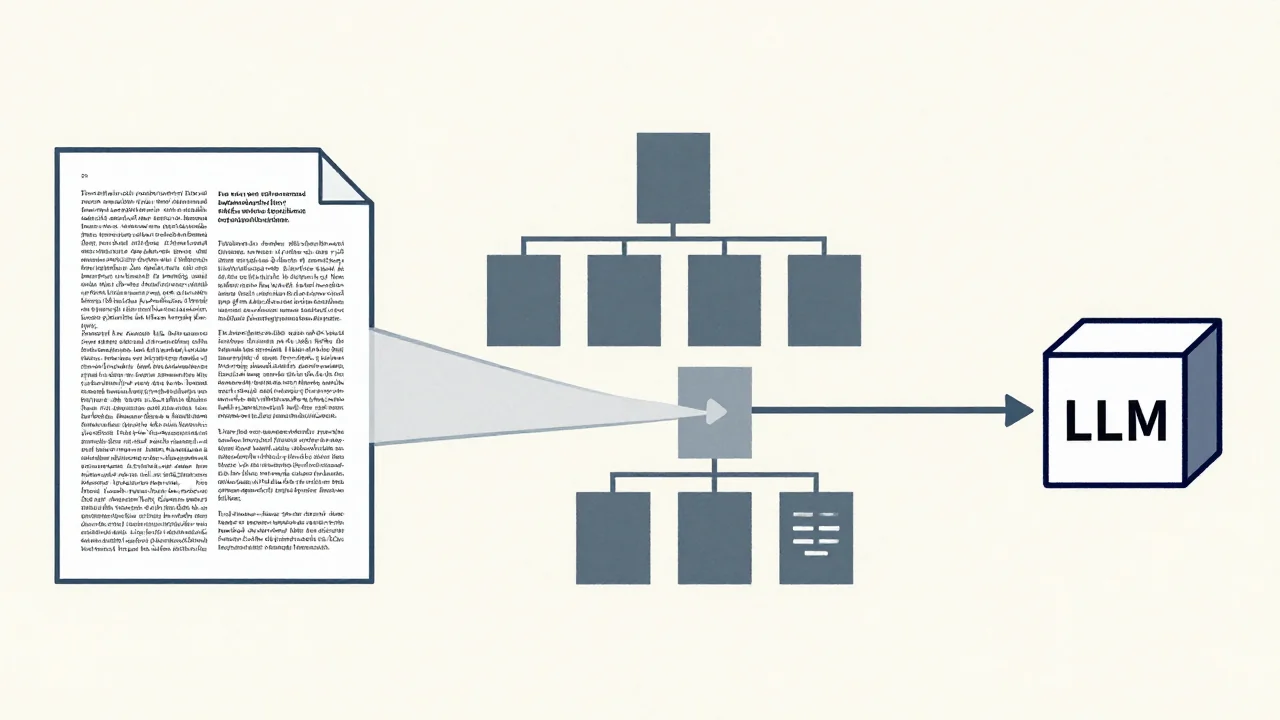
복잡한 문서 분석에 혁신을 가져온 PageIndex는 기존의 벡터 DB 대신 계층적 트리 인덱스를 사용합니다. 이는 사람이 보고서를 읽듯, LLM이 추론 과정을 거쳐 정보를 검색하는 방식입니다.
- 단순히 단어의 유사성을 찾는 것이 아닌 '관련성'에 초점을 맞추기 때문에, 법률/재무 등 전문 문서에서 높은 정확도와 출처를 명확하게 추적할 수 있습니다.
- 방대한 양의 문서를 다룰 때 발생하는 컨텍스트 창 제한 및 과도한 비용 문제를 해결하며, 검색 과정 전체가 투명하고 신뢰성 높습니다.
- 텍스트 PDF는 로컬 모드로 사용 가능하지만, 스캔 이미지나 대규모 코퍼스 분석은 클라우드 서비스(PageIndex Cloud)를 통해 파일 시스템 레벨까지 확장할 수 있습니다.
PageIndex는 기존의 를 사용하지 않는(vectorless), 추론 기반 엔진입니다. 이 시스템은 단순한 의미적 유사성 검색에 의존하기보다, 사람이 보고서를 읽듯이 계층적 트리 인덱스를 구축하고 이 이를 따라 적으로 탐색하며 정보를 검색합니다. 이러한 접근 방식은 법률 문서나 재무 보고서와 같은 복잡하고 긴 전문 문서에서 높은 관련성을 확보할 수 있으며, 결과에 대한 출처를 명확하게 추적(traceable)하고 설명 가능하도록 만듭니다.
PageIndex는 문서를 인덱싱할 때 트리 구조를 생성하며, 검색 과정에서는 LLM이 이 트리를 따라 정보를 찾아냅니다. 따라서 금융 보고서, 법률 문서, 기술 매뉴얼 등 장문의 전문 자료에 특히 적합합니다. 사용 환경에 따라 로컬 모드에서 텍스트 기반 PDF 처리가 가능하지만, 스캔 이미지나 대규모 코퍼스 분석을 위해서는 클라우드 서비스(PageIndex Cloud)를 활용할 수 있습니다. 클라우드는 파싱, OCR, 이미지 이해 등 다양한 기능을 지원하며 파일 시스템 레벨까지 확장하여 전체 코퍼스를 추론할 수 있게 합니다.
성능 및 비용 효율성 측면에서도 강점을 보입니다. PageIndex는 FinanceBench 평가에서 98.7%의 정확도를 달성하며 벡터 기반 RAG(50%)를 크게 능가했습니다. 또한, 검색 시 전체 PDF 파일을 컨텍스트로 전달하는 방식과 비교했을 때, PageIndex는 추론 과정에서 도달한 노드만 읽기 때문에 비용 효율적이며, 문서 크기에 따른 과도한 비용 증가 문제를 해결합니다.
용어 풀이
- 벡터 데이터베이스
- 임베딩을 저장하고 의미가 비슷한 항목을 빠르게 찾아 주는 데이터베이스.
- RAG
- 답하기 전에 관련 문서를 찾아 그 내용을 근거로 답하게 하는 방법.
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.