개발도구 도구
LLM을 넘어선 로컬 의사결정 모델 구동 플랫폼 Ollaya
ollaya-dev/ollaya
 GitHub
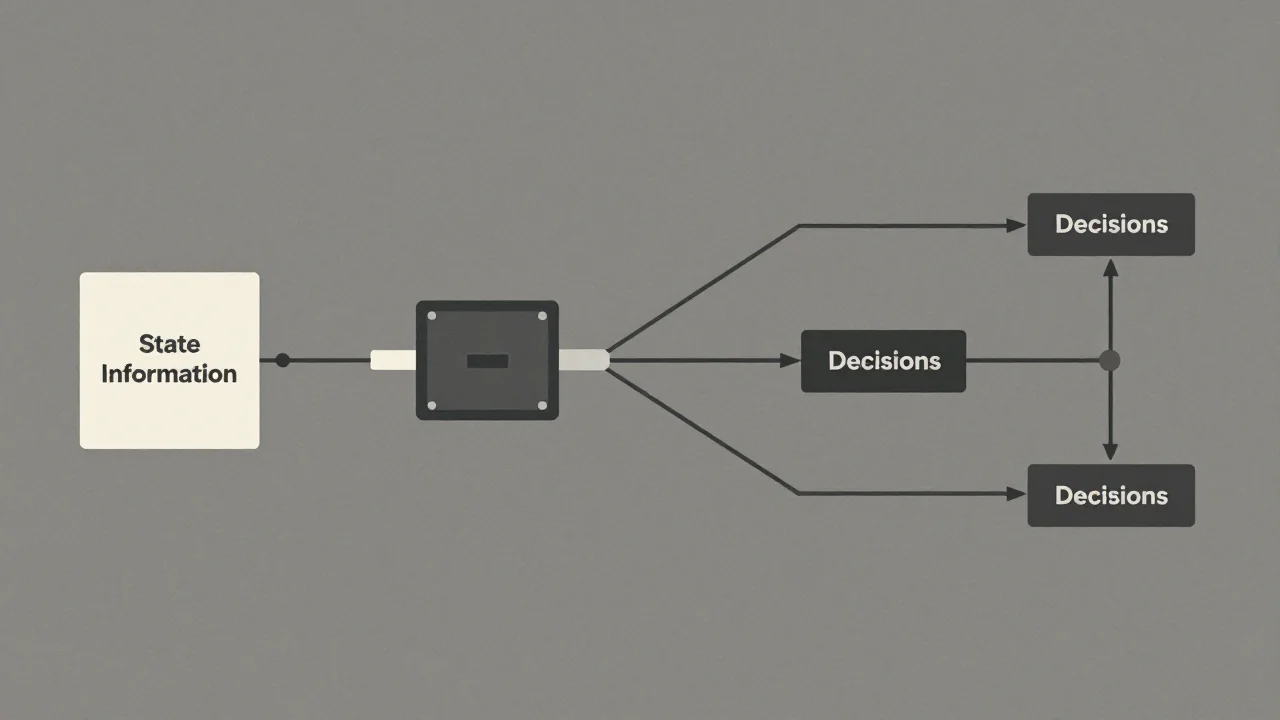
Ollaya는 일반적인 텍스트 생성 AI와 달리, 입력된 상태 정보에 대해 미리 정의된 질문을 던지고 확률 기반의 '결정'만을 내리는 전문 모델들을 로컬에서 구동합니다.
세 줄 요약
- TypeSafe 등 기존 API 규격과 완벽하게 호환되도록 설계되어, 에이전트나 자동화 워크플로우에 빠르고 정확하게 통합할 수 있습니다.
- 단순한 답변을 넘어 의도(Intent), 긴급성, 불만 정도 등을 정량적인 확률로 파악하여 복잡한 비즈니스 로직 판단에 활용할 수 있습니다.
- 다양한 전문 모델을 지원하며 GPU 환경에서 최적의 성능을 제공하지만, CPU 구동도 가능하므로 사용 목적에 맞는 특화된 모델 선택이 중요합니다.
Ollaya는 일반적인 텍스트 생성 AI와 달리, 입력된 상태 정보(메시지, 이메일 등)와 질문을 받아 확률 기반의 '결정'만을 반환하는 전문 모델들을 로컬에서 구동합니다. 이 결정 모델은 단일 순방향 패스(forward pass)를 통해 밀리초 단위로 정밀한 확률을 제공하며 텍스트 생성을 하지 않습니다.
Ollaya는 기존 TypeSafe의 `/v1/systemone` 와이어 포맷과 호환되도록 설계되어, 환경 변수 설정 변경만으로 기존 Jev 클라이언트가 작동할 수 있습니다. 또한 Linux, macOS, Windows 등 다양한 운영체제와 Docker를 통해 설치 및 구동이 가능하며, NVIDIA 사용 시 런타임 지원도 제공합니다.
플랫폼은 `winnow:e4b`와 같은 다양한 전문 모델을 지원하며, 이들은 ONNX Runtime(CPU/CUDA) 또는 llama.cpp()를 통해 구동됩니다. 예를 들어, RTX 4090 환경에서 다섯 가지 질문에 대한 추론 시간이 89ms로 보고되었으며, 사용자는 목적에 맞는 특화된 모델을 선택할 수 있습니다.
용어 풀이
- GPU
- 많은 계산을 한꺼번에 처리하는 칩. AI 학습과 실행에 가장 많이 써요.
- CUDA
- 엔비디아 GPU에서 계산 프로그램을 돌리게 해 주는 개발 플랫폼.
- GGUF
- 언어 모델을 개인 PC에서 돌리기 쉽게 담는 파일 형식. llama.cpp 계열 도구에서 써요.