모델 뉴스
54GB 모델을 12.3GB로 압축한 고성능 LLM 공개
orcarouter/OrcaSAQ-2-27B
 Hugging Face
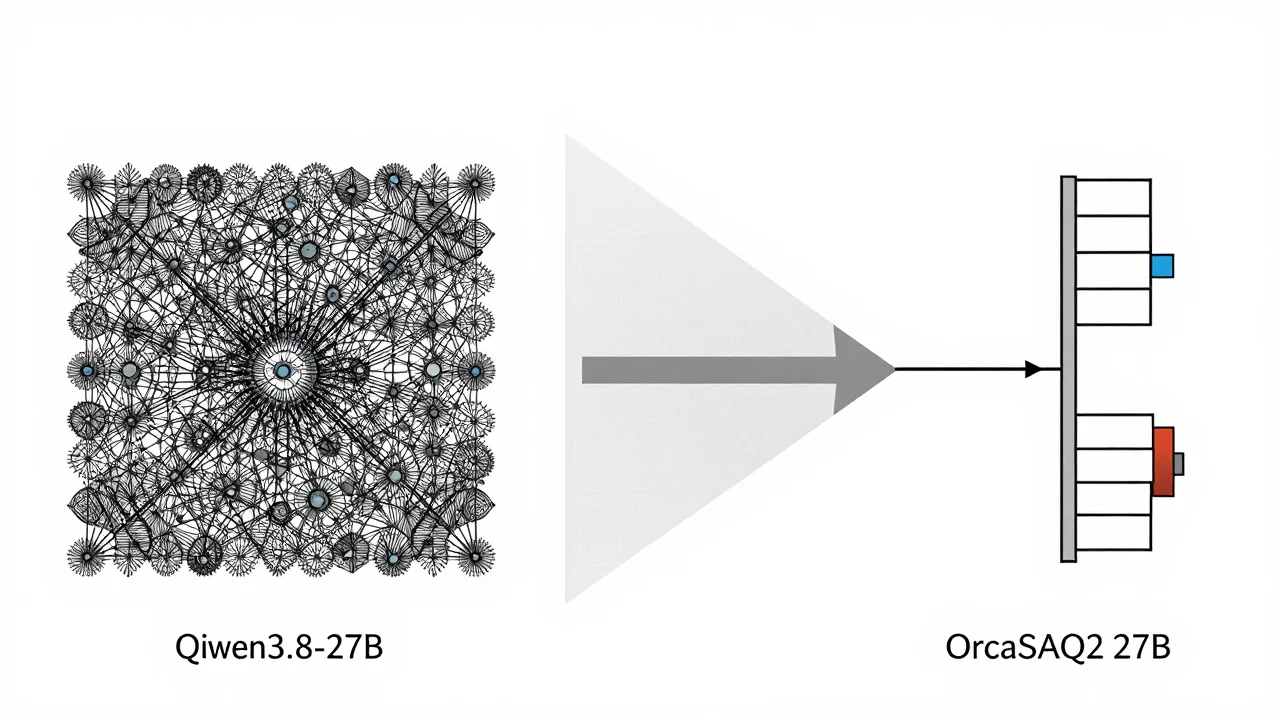
대규모 언어 모델 Qwen3.8-27B를 독자적인 민감도 기반 양자화 시스템으로 압축한 'OrcaSAQ2 27B'가 공개되었습니다.
세 줄 요약
- 원본 BF16 체크포인트(54GB) 대비 크기를 77% 이상 줄인 12.3GB 모델임에도, 성능 저하를 최소화하여 높은 정확도를 유지했습니다.
- 이 압축 기술 덕분에 메모리 제약 환경(예: 16GB GPU)에서도 고성능 LLM 구동이 가능해져 복잡한 에이전트 및 장기 추론 작업에 활용도가 높습니다.
- vLLM과 MTP 스펙큘레이티브 디코딩을 지원하며, 코딩, 도구 사용 등 까다로운 에이전트 워크로드에서 뛰어난 안정성을 보여줍니다.
OrcaSAQ2는 Qwen3.8-27B를 기반으로 개발된 민감도 인식 혼합 정밀 시스템입니다. 이 모델은 원본 BF16 체크포인트(54 GB) 대비 크기를 획기적으로 줄여 12.3 GB로 압축했습니다. 이러한 과정에서 저장 공간을 77.2% 절감했음에도 불구하고, 성능 저하를 최소화하여 +0.02%의 낮은 PPL 변화와 93.2%의 레벨 Top-1 일치도를 유지하는 것이 특징입니다.
OrcaSAQ2는 메모리 제약 환경에서도 높은 모델 품질을 보존하는 데 중점을 두었으며, 262K 컨텍스트를 지원합니다. 이 체크포인트는 코딩, 도구 사용, 추론 등 장기적인 작업에 최적화되어 있습니다. 또한 vLLM과 MTP 스펙큘레이티브 디코딩을 통해 높은 처리량(single-stream 기준 90.1 tok/s)을 제공하며, 복잡한 상태 기반 실행 환경에서도 안정성을 유지합니다.
이러한 경량화 덕분에 원래의 54 GB BF16 체크포인트로는 구동이 어려웠던 16 GB 와 같은 제한된 하드웨어에서도 배포가 가능해졌습니다. 실제 성능 테스트 결과, OrcaSAQ2 27B는 SWE-bench에서 70.0%를 기록하고 Terminal-Bench 2.1에서는 58.4%의 점수를 달성하며 압축 모델로서 뛰어난 장기 추론 능력을 입증했습니다.
용어 풀이
- 양자화
- 모델 숫자의 정밀도를 낮춰 크기와 메모리 사용을 줄이는 기법. 품질이 조금 떨어질 수 있어요.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- GPU
- 많은 계산을 한꺼번에 처리하는 칩. AI 학습과 실행에 가장 많이 써요.