엔비디아 MJWarp와 Warp를 활용한 로봇 시뮬레이션 가속화
How to Use NVIDIA Warp and MjWarp to Accelerate Robotics Simulation and Learning Workflows
 Hugging Face Blog
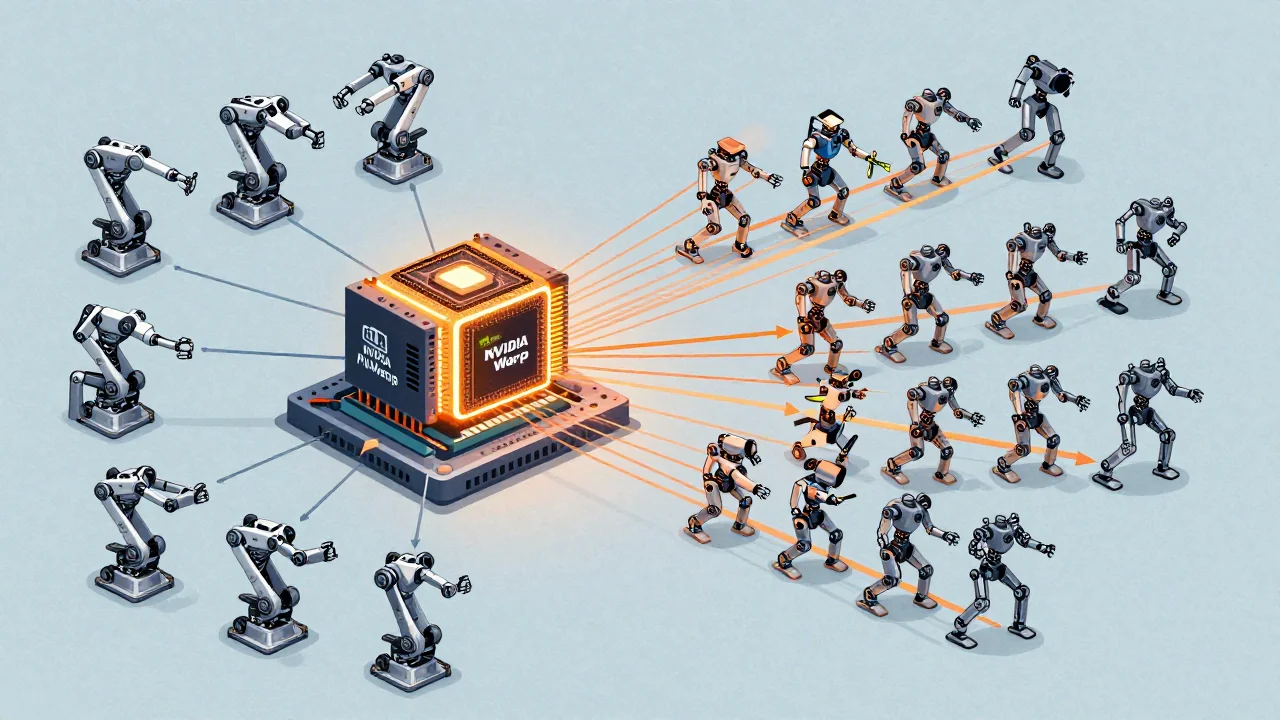
엔비디아는 NVIDIA Warp 기반의 MJWarp를 통해 로봇 시뮬레이션 워크플로우를 혁신적으로 가속화했습니다. 이는 MuJoCo 물리 엔진을 GPU 환경으로 가져와 대규모 병렬 배치 처리를 가능하게 합니다.
- MJWarp의 핵심 강점은 개별 시뮬레이션 속도(Latency)보다 '총처리량(Aggregate Throughput)' 극대화입니다. 수백 개의 독립적인 가상 환경을 동시에 구동하여 데이터 샘플링에 최적화되었습니다.
- 이를 통해 로봇 공학 및 AI 연구자들은 방대한 규모의 데이터셋 확보가 가능해지며, 복잡한 물리적 상호작용 기반의 정책 학습에 큰 도움을 받습니다.
- 사용 시에는 병렬 환경 수와 접촉/제약 조건 등의 버퍼 크기 설정을 세밀하게 조정해야 하며, '단일 지연 시간'과 '총처리량' 개념을 명확히 구분하는 것이 중요합니다.
MJWarp는 NVIDIA Warp 기반으로 개발되었으며, 기존 MuJoCo 모델을 환경에 맞게 확장하여 대규모 병렬 배치 처리를 가능하게 합니다. MJWarp는 하나의 호출로 수백 또는 수천 개의 독립적인 가상 세계(world) 상태를 동시에 전진시키는 것이 핵심입니다. 이는 로봇 시뮬레이션 워크플로우를 개별 CPU 기반 작업에서 GPU 기반의 배치 처리 방식으로 전환시킵니다.
MJWarp의 주요 이점은 단일 환경의 지연 시간(Latency)을 줄이는 것보다, 단위 시간당 완료되는 총 세계 스텝 수인 '총처리량(Aggregate Throughput)'을 극대화하는 데 있습니다. 이러한 높은 병렬 처리 능력은 이나 대규모 데이터 샘플링이 필요한 연구 분야에 특히 유리합니다. 또한, MJWarp의 기반 기술인 NVIDIA Warp는 Python으로 고성능 GPU 커널을 작성할 수 있게 하며 성능, 사용 편의성, 미분 가능성을 제공합니다.
MJWarp를 활용하기 위해서는 작업 흐름(workflow)이 변경됩니다. 기존 MuJoCo가 단일 CPU 환경에 적합했다면, MJWarp는 모델과 배치된 상태를 GPU에 올려 한 번의 호출로 전체 배치를 진행합니다. 이 과정에서 총 병렬 환경 수(nworld), 예상 접촉 횟수(nconmax) 등 배치 자원을 정의하는 를 정확하게 설정해야 합니다.
용어 풀이
- GPU
- 많은 계산을 한꺼번에 처리하는 칩. AI 학습과 실행에 가장 많이 써요.
- 강화 학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.
- 매개변수
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.