검증기를 활용한 LLM의 설명 가능 추론 강화 방안
A Verifier-Guided Explainable Reasoning Framework with Gold-Anchored QLoRA, Task-Aware Mixture-of-Experts, and Group-Relative RLVR
 arXiv
LLM의 추론 설명력 부족 문제를 해결하기 위해 검증기 기반의 새로운 프레임워크가 개발되었습니다. 이 시스템은 QLoRA, 태스크별 라우팅, RLVR을 결합하여 투명한 답변 생성을 목표로 합니다.
- 강화학습(RLVR)이 모델 자체의 추론 구조를 크게 개선하는 한편, 별도의 심볼릭 검증기는 최종 답안의 시스템적 신뢰도를 보완적으로 높여줍니다.
- AI가 제시하는 답변이 단순히 정답 여부를 넘어 근거와 과정까지 논리적으로 검증 가능하다는 점은 학술 및 교육 분야 응용에서 핵심적인 가치로 부상하고 있습니다.
- 본 프레임워크의 성공은 신경망 기반 학습과 외부 전문 지식(심볼릭 검증)이 유기적으로 결합된 하이브리드 구조에 달려있음을 보여줍니다.
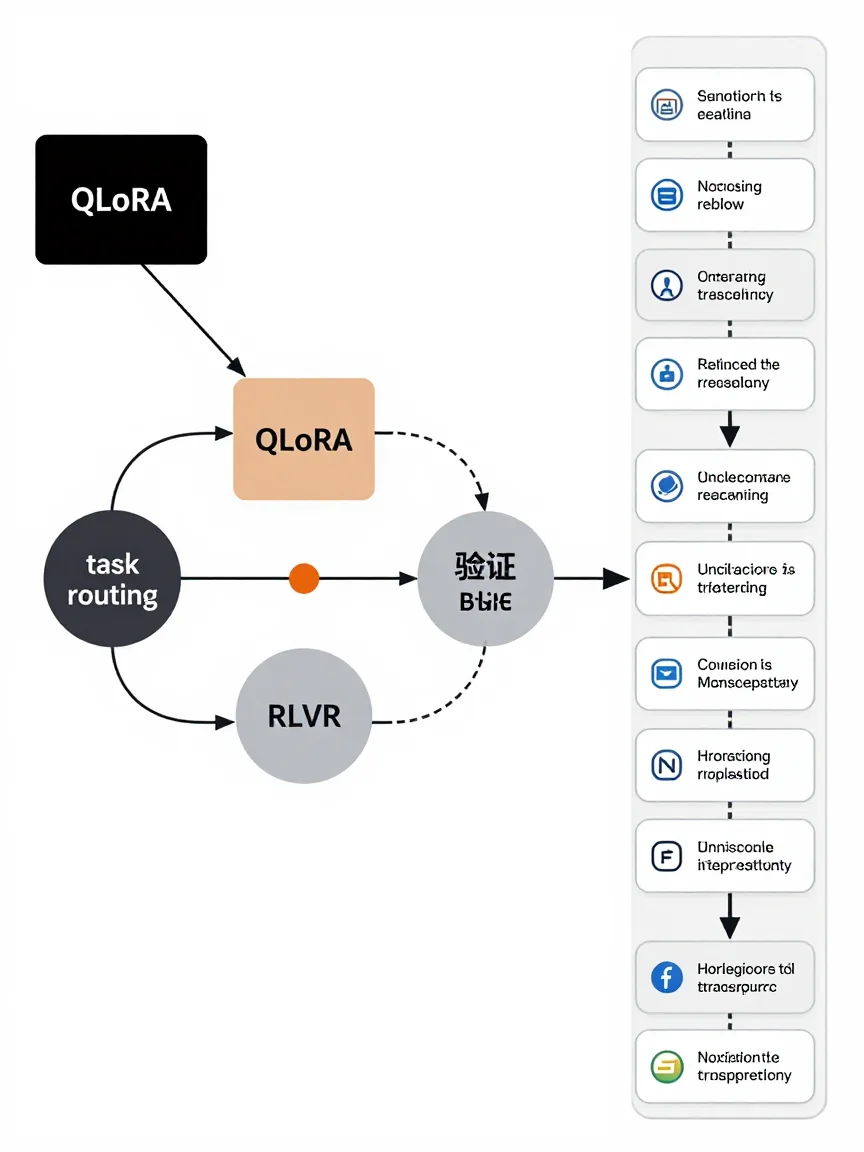
(LLMs)은 강력한 추론 능력을 보이지만, 그 과정에 대한 설명이 일관성이 부족하거나 검증하기 어려운 경우가 있습니다. 이에 연구진은 투명한 교육용 질의응답을 위해 금본위 QLoRA 학습, 태스크별 심볼릭 라우팅, 그리고 그룹-상대 RLVR을 결합한 검증기 기반의 설명 가능한 추론 프레임워크를 제안했습니다.
이 시스템에서 로직 문제는 FOL/Z3 검증기에 할당되고 물리 문제는 공식 및 단위에 민감한 심볼릭 솔버가 담당합니다. 후보 응답은 답변 정확성(P1), 근거 또는 단위 일관성(P2), 추론 깊이 및 설명 가능성(P3)의 세 가지 차원에서 평가됩니다. 최종적으로 금본위 기반 자기일관성 집계 후, 선택적으로 물리 검증기가 시스템 수준의 보정 작업을 수행합니다.
438개의 테스트 예시를 통해 실험한 결과, RLVR을 적용했을 때 P3(추론 깊이 및 설명 가능성)는 50.68%에서 72.20%로 증가했습니다. 또한, 이 결과를 종합하면 RLVR은 명시적인 추론 구조를 강화하는 역할을 하며, 심볼릭 검증기는 시스템 수준에서 답변의 신뢰도를 보완적으로 개선함을 확인할 수 있었습니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.