LLM 기반 체계적 문헌 고찰을 위한 벤치마크 개발
SciLitBench: Benchmark and Design Principles for LLM-Powered Systematic Literature Reviews
 arXiv
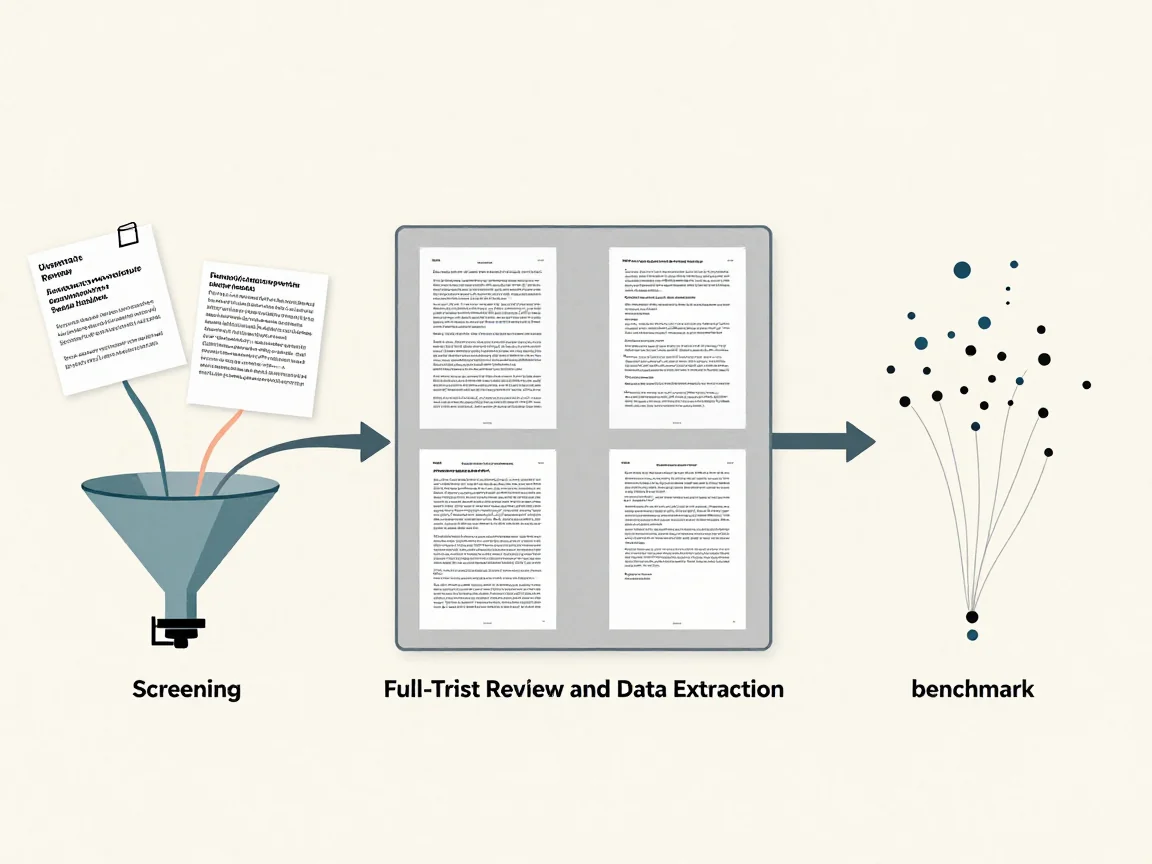
LLM 기반 체계적 문헌 고찰(SLR)의 성능을 평가하기 위해, 제목/초록 스크리닝부터 전문 검토 및 데이터 추출까지 다단계 과정을 포괄하는 벤치마크 'SciLitBench'가 개발되었습니다.
- 연구 결과, 명시적 포함/제외 기준 적용 시 초록 스크리닝의 F2 점수가 28.8% 향상되었으며, 전문 검토 단계에서도 근거 제시가 15% 개선되는 효과를 확인했습니다.
- 이 연구는 LLM이 높은 재현율을 보이는 초기 스크리닝 단계와 모든 증거를 완벽히 추출해야 하는 데이터 추출 단계 사이의 실질적인 성능 한계를 명확히 보여줍니다.
- 특히 데이터 추출 과정에서는 정보 유형에 따라 신뢰성 편차가 커, 출판 연도 같은 단순 정보는 정확도가 높았으나 계산 방식 등은 취약점이 발견되었습니다.
체계적 문헌 고찰(Systematic reviews)은 수천 개의 기록에 걸쳐 지속적인 인간의 판단이 필요한 작업이다. 기존 평가는 검토 단계를 개별적으로 다루는 경향이 있었으나, 본 연구에서는 제목/초록 스크리닝, 전문 검토, 그리고 스키마 기반 데이터 추출을 포괄하는 다단계 인 SciLitBench를 도입했다. 이 벤치마크는 총 42,981개의 검색 기록과 1,012개의 전문, 그리고 888개 논문에 대한 주석을 활용하여 구축되었다.
22개의 오픈 LLM 모델을 대상으로 실험한 결과, 명시적인 포함 및 제외 기준을 적용했을 때 제목/초록 스크리닝의 $F_2$ 점수가 28.8% 향상되는 것이 확인되었다. 또한 연구자 작성의 근거(rationales)를 활용하여 전문 검토 단계에서는 성능이 15% 개선되는 효과가 나타났다.
데이터 추출 과정에서는 정보 유형에 따른 신뢰성 편차가 크게 관찰되었다. 출판 연도 같은 단순 정보는 0.97의 정확도를 보였으나, 계산 방식과 같은 복잡한 정보는 Jaccard 오버랩이 0.37로 떨어지는 등 성능 저하가 나타났다. 가장 강력한 모델들조차 주석 평가 증거의 25%에서 30%만을 회복하는 것으로 분석되었다.
용어 풀이
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.
- 가중치
- 학습으로 정해진 모델 내부의 숫자 값. 내려받는 모델 파일의 본체예요.