AI 에이전트 연구
옵션-크리틱의 성능 한계와 정책 괴사 현상 분석
When Do Options Help? Policy Necrosis and Redundant Coverage in Option-Critic
 arXiv
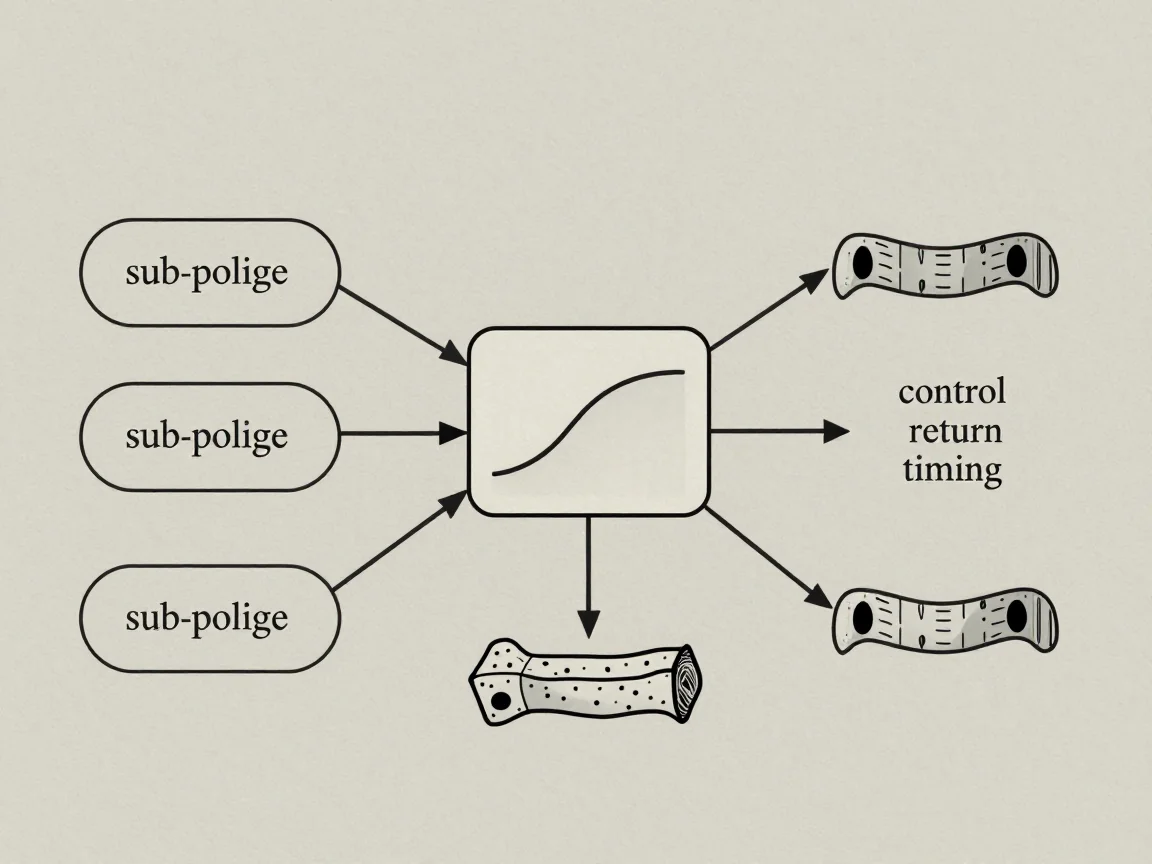
옵션-크리틱은 하위 정책(options)과 제어권 반환 시점을 학습하는 강화학습 기법입니다. 본 연구는 이 모델의 성능을 저해하는 세 가지 핵심 문제점들을 이론적, 실험적으로 분석했습니다.
세 줄 요약
- 단순히 옵션 수를 늘리는 것만으로는 성능 향상에 한계가 있으며, 개별 정책이 충분히 탐색하지 못하는 '정책 괴사(policy necrosis)' 현상이 발생하고 종료 규칙 자체가 학습을 방해할 수 있습니다.
- 이는 RL 시스템 설계 시 단순히 복잡성이나 커버리지 확대만으로는 부족하며, 각 하위 정책 내부에서 충분한 탐험과 안정적인 제어 메커니즘 확보가 필수적임을 보여줍니다.
- 특히, 여러 옵션을 결합해도 모든 옵션이 같은 상태에서 동시에 실패할 경우 전체 성능이 급격히 떨어질 수 있으므로, 시스템의 전반적인 안정성을 면밀히 점검해야 합니다.
옵션-크리틱은 하위 정책(options)과 제어권 반환 시점을 학습하는 강화학습 기법입니다. 본 연구는 이 모델의 성능을 저해하는 세 가지 핵심 문제점들을 이론적, 실험적으로 분석했습니다.