소셜 미디어 우울증 감지를 위한 시각 정보 보완 사전 기술
VIS-DICT: A Visual Dictionary for Missing Modality Imputation in Social Network Depression Detection
 arXiv
소셜 미디어 기반 우울증 감지에는 텍스트와 이미지를 결합한 멀티모달 분석이 필수적이지만, 실제 데이터의 이미지 누락 문제가 큰 난관입니다.
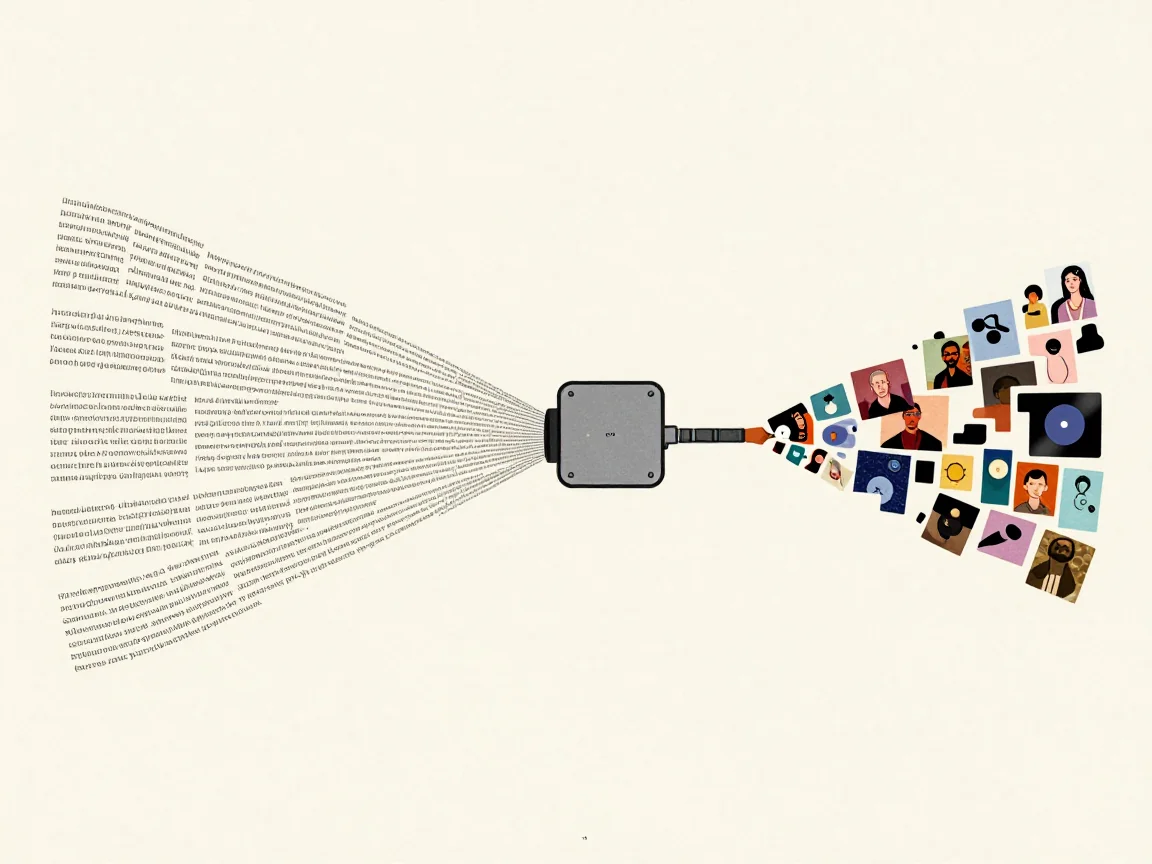
- 연구진은 'Vis-Dict'라는 사전(Dictionary) 기반 방식을 도입하여 단어 자체를 평균 이미지 벡터에 연결해 누락된 시각 정보를 추정했습니다.
- 이 방식은 복잡한 생성 모델을 사용하지 않고도 높은 성능을 달성하며, 추가 학습 매개변수가 없어 실용성과 안정성이 매우 높습니다.
- 단순히 단어와 시각적 특징을 직접 연결하는 것이 멀티모달 데이터의 결측치를 처리하는 효과적이고 효율적인 방법임을 보여줍니다.
사회적 네트워크의 게시물을 추적하는 것은 우울증의 초기 징후를 포착하는 데 도움이 됩니다. 최근 연구들은 텍스트와 이미지를 결합한 분석이 텍스트만 사용하는 것보다 우울증 감지에 더 효과적임을 보여줍니다. 하지만 실제 소셜 미디어 게시물 중에는 이미지가 누락된 경우가 많아, 기존의 멀티모달 모델을 적용하는 데 어려움이 있었습니다. 대부분의 기존 방식은 추가적인 학습이 필요한 검색 또는 생성 모델을 사용하여 누락된 이미지를 채우는 방식을 사용했습니다.
본 논문에서는 'Vis-Dict'라는 사전(dictionary) 기반 방법을 도입하여, 단어와 완전한 훈련 게시물에서 얻은 평균 이미지 벡터를 연결함으로써 누락된 시각적 특징을 구축합니다. 이렇게 추정된 시각적 특징들은 텍스트 정보와 결합되어 사용자의 시간 경과에 따른 행동 변화를 추적하는 데 활용됩니다.
Vis-Dict는 소셜 미디어 데이터셋의 사용자 타임라인(최대 512개 게시물)을 대상으로 테스트되었으며, 다른 누락 데이터 처리 방법들과 비교되었습니다. 그 결과 F1-점수 0.9454와 ROC-AUC 0.9890이라는 높은 성능을 달성했습니다. 특히 Vis-Dict는 이미지 생성을 위해 학습 가능한 가 전혀 없음에도 불구하고 이러한 강력한 성능을 보여주었으며, 이는 단어를 시각적 특징에 직접 연결하는 것이 효과적이고 실용적인 방법임을 입증합니다.
용어 풀이
- 멀티모달
- 글뿐 아니라 이미지·음성·영상처럼 여러 형태의 입력을 함께 다루는 것.
- 매개변수
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.