도메인 특화 사전 학습을 위한 표적 웹 크롤링 기술 'Data Scout'
Data Scout: Targeted Web Crawling for Domain-Specific Pretraining Corpora
 arXiv
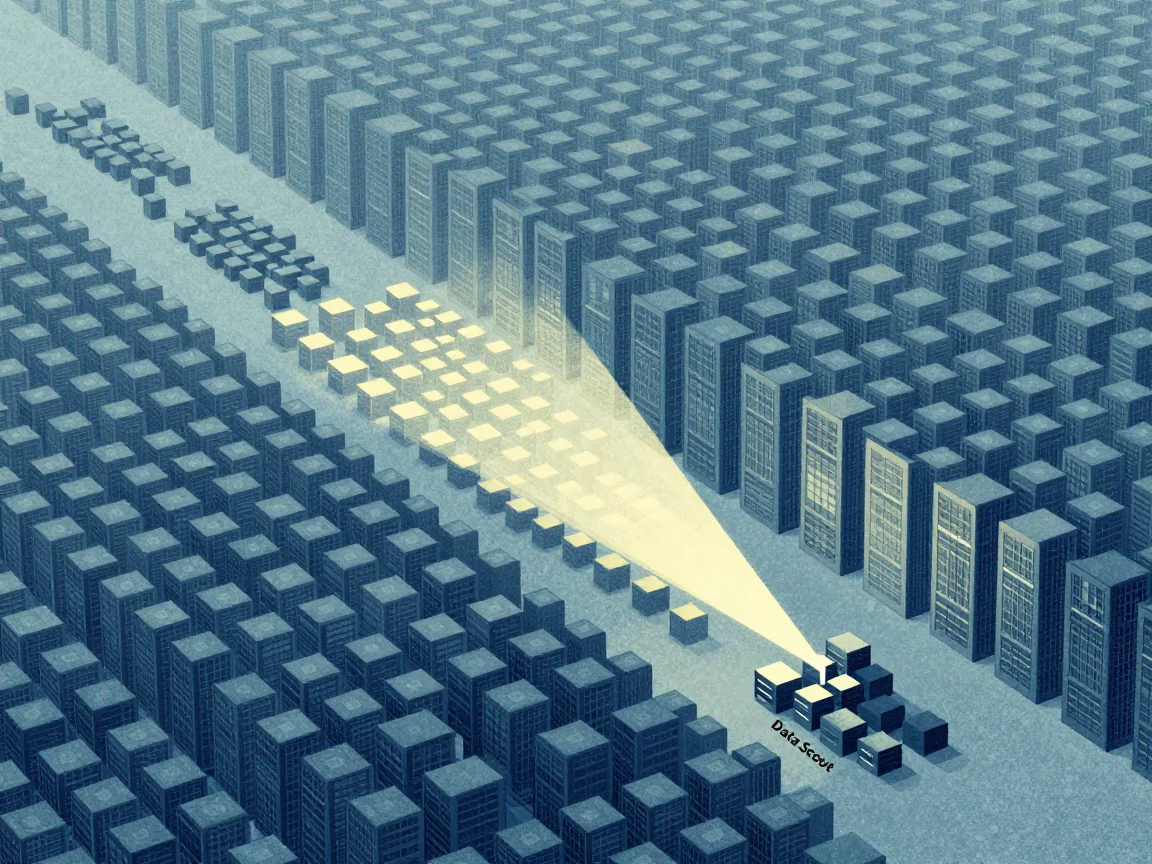
기존의 대규모 웹 아카이브 필터링 방식의 한계를 극복하기 위해, 'Data Scout'는 특정 주제에 맞춰 필요한 영역만 선별적으로 크롤링하는 혁신적인 방법을 제시합니다.
- 이 기술은 LLM을 활용해 주제를 세분화하고, 사용자가 제공한 분류기(probe)로 서브도메인 단위의 관련성을 검증하여 고품질 데이터를 매우 효율적으로 수집합니다.
- 일반 크롤러가 놓치거나 접근하기 어려웠던 전문 분야의 희귀 데이터셋을 대량 확보할 수 있어, AI 모델 학습에 큰 진전을 가져올 것으로 기대됩니다.
- 다만 이 방법은 해당 도메인의 관련성을 정확히 판단하는 분류기(probe)가 필수적이며, 이 기준이 기술 적용의 핵심 전제 조건입니다.
기존의 도메인 특화 사전 학습 코퍼스 구축 방식은 CommonCrawl과 같은 대규모 웹 아카이브를 필터링하는 것이 주류였습니다. 이 방법은 일반적인 영역에서는 효과적이지만, 관련 콘텐츠가 희소하고 인기 기반 크롤러의 접근 범위를 벗어나는 전문 분야에서는 한계에 부딪힙니다. Data Scout는 이러한 문제를 해결하기 위해 기존 방식과 달리 아카이브를 필터링하는 대신 목표 지향적인(targeted) 방식으로 크롤링을 직접 유도합니다.
이 기술은 을 활용하여 근본 주제를 분류 체계(taxonomy)와 수많은 검색 쿼리로 확장합니다. 이렇게 얻은 URL들은 서브도메인별로 그룹화되며, 사용자가 제공하는 분류기(probe)를 통해 검증됩니다. 이 과정은 관련성이 서브도메인 수준에서 명확한 경계를 가지는 특성을 이용하며, 예를 들어 수학 분야에서는 한 페이지가 인접한 서브도메인 대비 21배 더 관련성이 높다는 점을 활용합니다.
실제 적용 사례로 FineMath 분류기를 사용했을 때, 크롤링된 페이지 중 21.9%가 고품질의 수학 콘텐츠임이 확인되었습니다. 이는 유사한 웹 샘플을 필터링했을 때의 0.31% 대비 70배 높은 수치입니다. 또한 이 과정은 CommonCrawl에 포함되지 않은, 학습에 유용하지만 접근하기 어려웠던 페이지 중 63.2%를 확보할 수 있었습니다.
용어 풀이
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.