잠재 공간에서 시각 및 언어 표현을 통합한 폐 엑스레이 분류
Integrating Unimodal and Vision-Language Representations in Latent Space for Multi-Label Chest X-Ray Classification
 arXiv
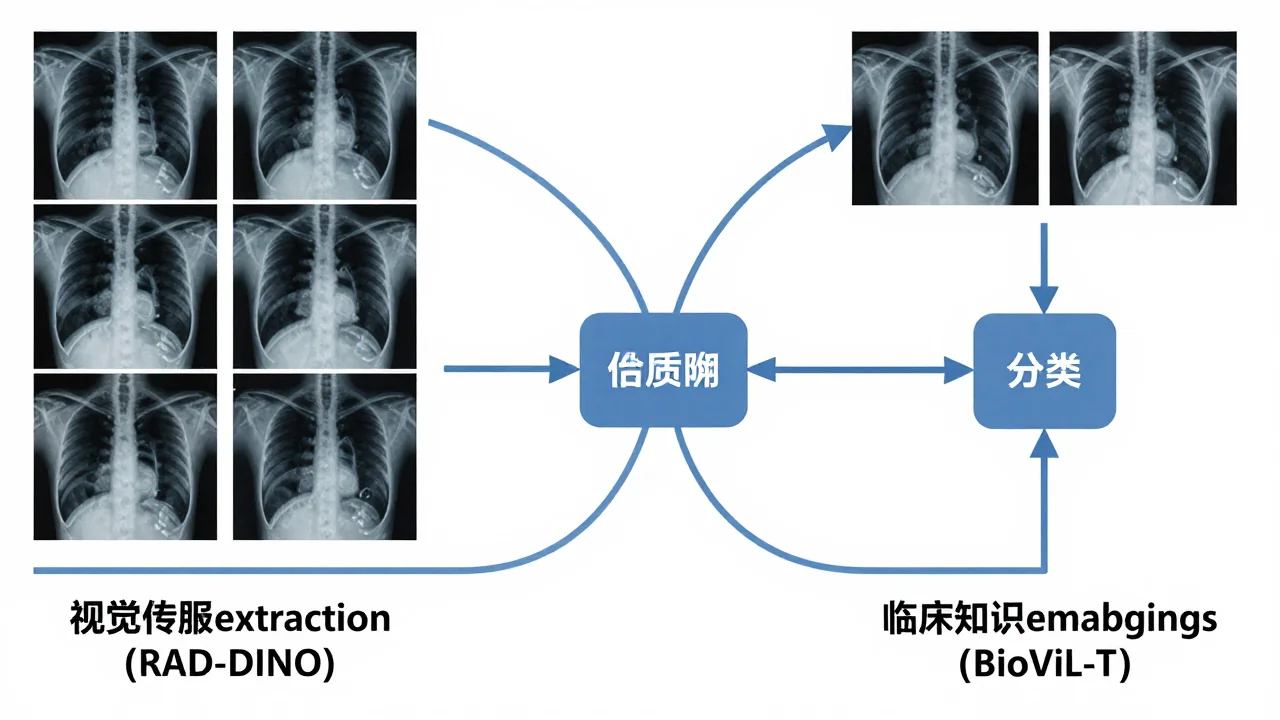
폐 엑스레이의 다중 레이블 분류 정확도를 높이기 위해, 시각적 특징(RAD-DINO)과 임상 지식 기반 표현(BioViL-T)을 결합한 새로운 AI 프레임워크를 제안했습니다.
- 특히, 두 가지 임베딩 소스를 잠재 공간에서 정제 후 융합하는 하이브리드 방식이 단순 초기 결합보다 월등히 높은 성능 향상을 입증했습니다.
- 이는 의료 영상 분석 분야에서 시각 정보와 임상 지식이 상호 보완적임을 보여주며, 차세대 진단 AI 개발에 중요한 방법론적 통찰을 제공합니다.
- 다만, 본 연구는 MIMIC-CXR-JPG 데이터셋 내에서만 평가되었으므로, 다른 의료 환경이나 기관의 데이터에 적용 시 추가 검증이 필수적입니다.
다중 레이블 흉부 X-ray 분류를 위해, 본 연구는 RAD-DINO의 단일 모드(unimodal) 표현과 BioViL-T의 비전-언어(vision-language) 표현을 결합한 프레임워크를 제안했다. 이 방법론은 MIMIC-CXR-JPG 데이터셋에서 14개 레이블 분류에 적용되었으며, 두 소스를 잠재 공간(latent space)에서 개별적으로 정제하고 정규화한 후, 세 개의 분기(branch)에 걸쳐 융합하는 방식을 사용했다.
실험 결과, RAD-DINO가 BioViL-T보다 독립적인 성능이 우수했으나, 초기 결합 방식(early fusion)을 통해 결과를 개선할 수 있었다. 최적의 모델은 평균 AUROC 0.840 및 mAP 0.467를 달성했다. 특히 잠재 공간에서 각 임베딩 소스를 정제한 하이브리드 융합 방식이 개별적인 임베딩 소스보다 일관되고 통계적으로 유의미한 성능 향상을 제공함을 보여주었다.
연구진은 이러한 결과가 시각 정보와 임상 지식이 상호 보완적임을 시사한다고 밝혔다. 다만, 본 연구는 MIMIC-CXR-JPG 데이터셋 내에서만 내부적으로 평가되었기 때문에, 다른 의료 기관의 데이터를 사용한 일반화 가능성은 추가적인 검증이 필요하다고 언급했다.
용어 풀이
- 임베딩
- 글이나 이미지의 의미를 숫자 목록으로 바꾼 것. 의미가 비슷한 것을 찾을 때 써요.