리서치 연구
비디오 이해를 위한 다중 교사 증류 모델 'Video-MOPD-8B'
Video-MOPD: Multi-Teacher On-Policy Distillation for Video Understanding
 arXiv
비디오 이해는 인식, 시간적 추론, 복합 추론 등 다양한 능력이 결합되어야 하는데, 이를 위해 'Video-MOPD-8B'라는 새로운 오픈 가중치 모델이 개발되었습니다.
세 줄 요약
- 개발진은 다중 교사 온-정책 증류(MOPD)와 강화 학습 최적화를 결합하여, 모델이 여러 전문가 지식을 종합적으로 습득하도록 설계했습니다.
- 일반 이해부터 시간적 근거 파악, STEM 추론까지 광범위한 영역에서 기존 모델 대비 최고 수준의 성능을 입증하며 높은 활용도를 보여줍니다.
- 신뢰성 기반 샘플링(RAIS) 기법으로 학습 데이터를 선별했으며, 훈련된 모델 가중치까지 공개되어 연구자들이 쉽게 접근할 수 있습니다.
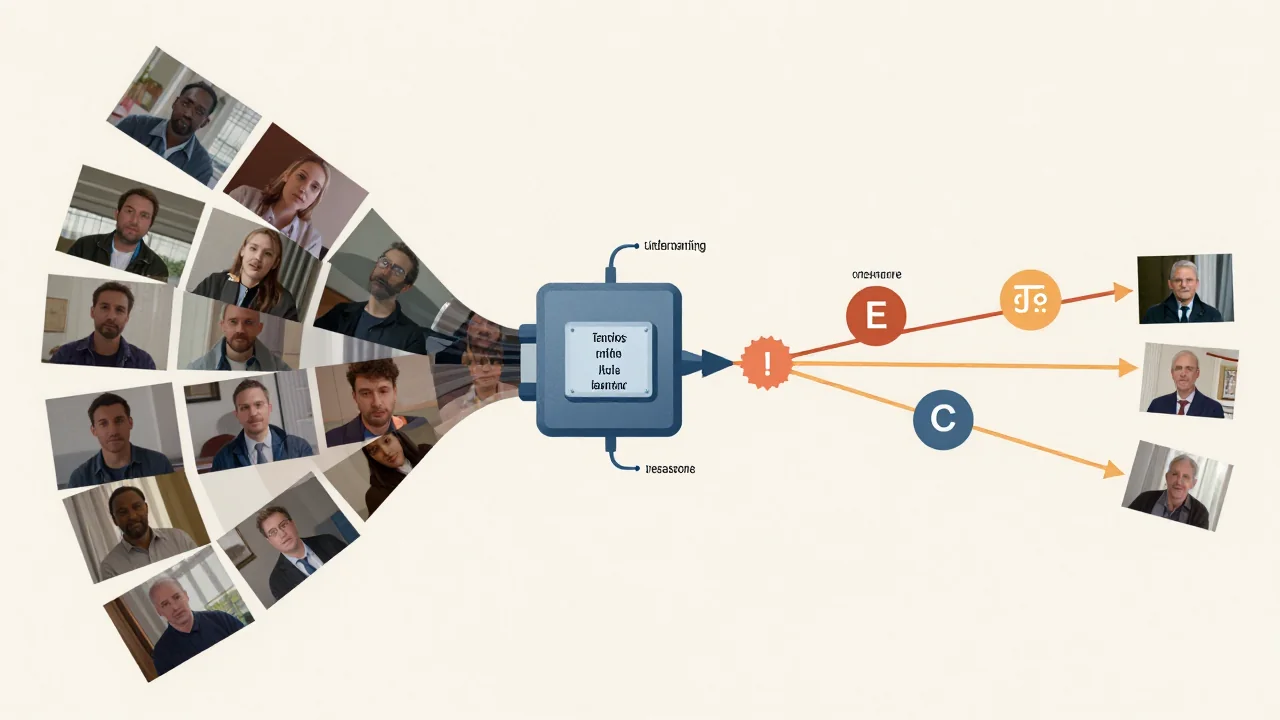
영상 이해는 인식, 시간적 추론, 그리고 복합적인 추론 능력이 결합되어야 하는 영역으로, 이러한 능력들을 단일 모델 내에서 동시에 최적화하기 어렵습니다. 연구진은 이 문제를 해결하기 위해 비디오 이해 전용 오픈 모델인 Video-MOPD-8B를 개발했습니다.
모델 성능 향상을 위해 세 가지 핵심 영역(비디오 시간적 근거 파악, 일반 영상 이해, 비디오 STEM 추론)에 걸쳐 표적 (RL) 최적화를 수행했습니다. 이 상호 보완적인 능력들은 다중 교사 온-정책 증류(MOPD)를 통해 통합되었으며, 이는 라우팅된 교사 피드백으로 학생이 생성한 궤적을 감독하여 전문가 지식을 집대성합니다. 또한, 신뢰성 기반 정보 샘플링(RAIS) 기법을 도입해 일관되게 신뢰할 수 있는 예시를 선별했습니다.
종합적인 실험 결과에 따르면, Video-MOPD-8B는 일반 비디오 이해, 시간적 근거 파악, 그리고 비디오 STEM 과제 등 다양한 에서 기존 모델 대비 최고 수준의 성능을 달성한 것으로 나타났으며, 훈련된 모델 가중치는 공개되어 있습니다.
용어 풀이
- 가중치
- 학습으로 정해진 모델 내부의 숫자 값. 내려받는 모델 파일의 본체예요.
- 강화 학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.