리서치 연구
VLM 프롬프트 학습, 저랭크 분해로 효율성 극대화
Low-Rank Prompt Learning for Vision-Language Models with Fixed-Token Bases
 arXiv
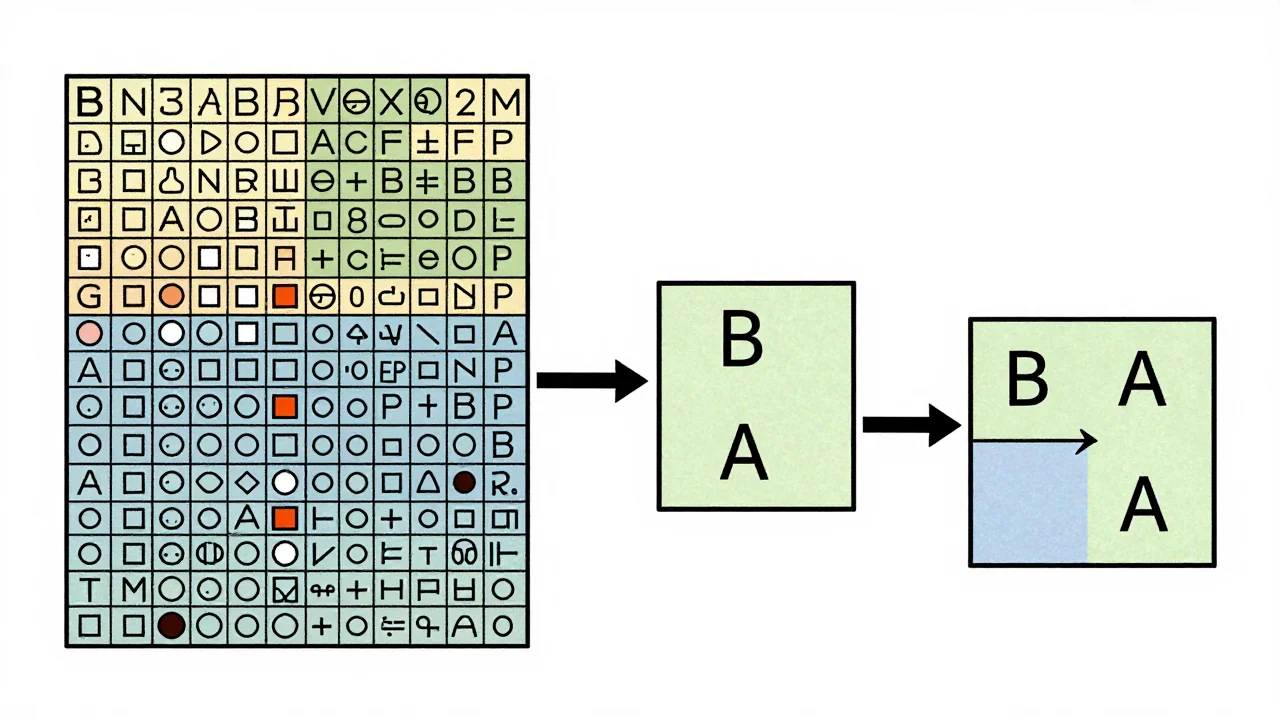
VLM의 프롬프트 학습에 사용되는 밀집 행렬을 저랭크 분해($\mathbf{P}=\mathbf{B}\mathbf{A}$)하여 파라미터 수를 획기적으로 줄이는 방법을 제안했습니다.
세 줄 요약
- 이 저랭크 방식은 기존 고밀도 프롬프트 학습 기법과 동등하거나 더 나은 성능을 보였으며, 특히 소수 예시 기반의 새로운 작업 수행에서 강점을 나타냈습니다.
- 가장 주목할 점은 토큰 기반($\mathbf{B}$) 자체를 별도로 학습할 필요 없이 임베딩 계수($\mathbf{A}$)만 학습해도 충분한 성능을 유지한다는 것입니다.
- 적응 과정이 주로 임베딩 계수에 국한되므로, 토큰 기반을 고정하는 것이 파라미터 효율성과 최적화 안정성 측면에서 매우 실용적인 접근 방식임을 입증했습니다.
VLM의 프롬프트 학습에 사용되는 밀집 행렬을 저랭크 분해($\mathbf{P}=\mathbf{B}\mathbf{A}$)하여 파라미터 수를 획기적으로 줄이는 방법을 제안했습니다.