리서치 연구
구조화 데이터 분석을 위한 토큰 효율적 모델링 프레임워크 TEFM
TEFM: Token-Efficient Faithful Modeling for Structured Data
 arXiv
LLM이 중요 분야에 적용될 때 발생하는 토큰 비효율성과 신뢰성 문제를 해결하는 프레임워크 TEFM을 소개합니다.
세 줄 요약
- TEFM은 긴 구조화 데이터를 '행동 코드 토큰'으로 압축하여 효율성을 높이고, 이중 충실도 목표로 신뢰성 높은 추론 근거를 제시합니다.
- 임상 및 보안 등 중요 도메인에서 분류 정확도를 유지하면서도 토큰 사용량을 극적으로 줄여 실질적인 활용성을 확보했습니다.
- 다양한 도메인 데이터셋과 Qwen3, Gemma-2 등 여러 모델 백본을 통해 검증되어 구조화된 전문 영역에 최적화되었습니다.
본 논문은 을 중요 영역에 적용할 때 발생하는 두 가지 근본적인 문제, 즉 비효율성과 신뢰성 문제를 해결하는 TEFM(Token-Efficient Faithful Modeling)이라는 프레임워크를 제시합니다. TEFM은 구조화된 데이터 분석을 위해 설계되었으며, 이 접근 방식은 임상 및 보안과 같은 중요 도메인에서 LLM의 실질적인 활용성을 높이는 것을 목표로 합니다.
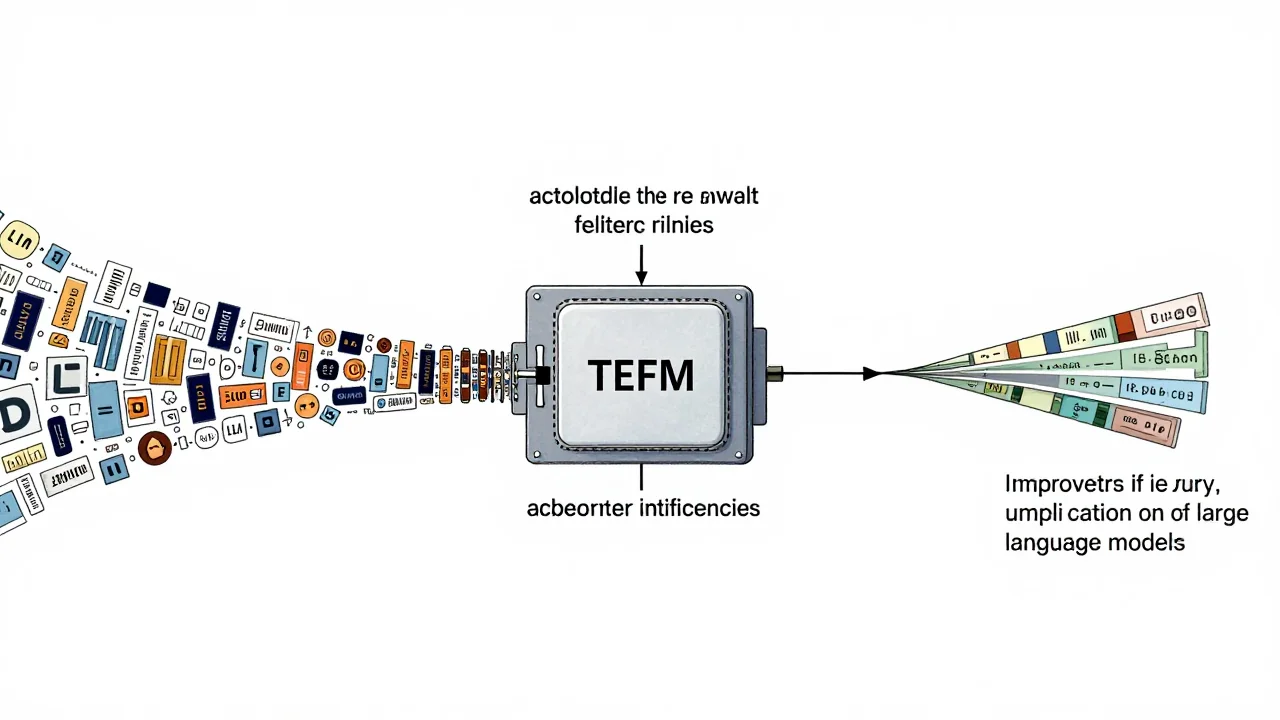
TEFM은 긴 구조화 관측 데이터를 '행동 코드 토큰(Behavioral Code tokens)'으로 압축하여 토큰 효율성을 확보합니다. 이 과정을 통해 정보 손실을 최소화하면서도 토큰 소비량을 획기적으로 줄일 수 있습니다. 또한, TEFM은 코드를 이용한 재구성 수준과 예측 수준의 충실도를 결합하는 '이중 충실도 목표(dual-fidelity objective)'를 통해 신뢰성 높은 추론 근거를 제시합니다.
다양한 도메인 데이터셋 및 Qwen3, Gemma-2, Phi-4와 같은 여러 모델 백본을 사용한 실험 결과에 따르면, TEFM은 분류 정확도를 유지하면서도 토큰 사용량을 크게 줄이는 성능을 보였습니다. 구체적으로 임상 분야에서는 약 1%의 토큰만 유지하고, 보안 도메인에서는 약 2%의 토큰만을 사용하여 높은 효율성을 입증했습니다.
용어 풀이
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.