단일 이미지로 애니메이션 가능한 3D 동물 모델 복원 기술
AnimalLift: Reconstructing Animatable 3D Animals from a Single Image by Learning Canonical Shape, Texture, and Fur Maps
 arXiv
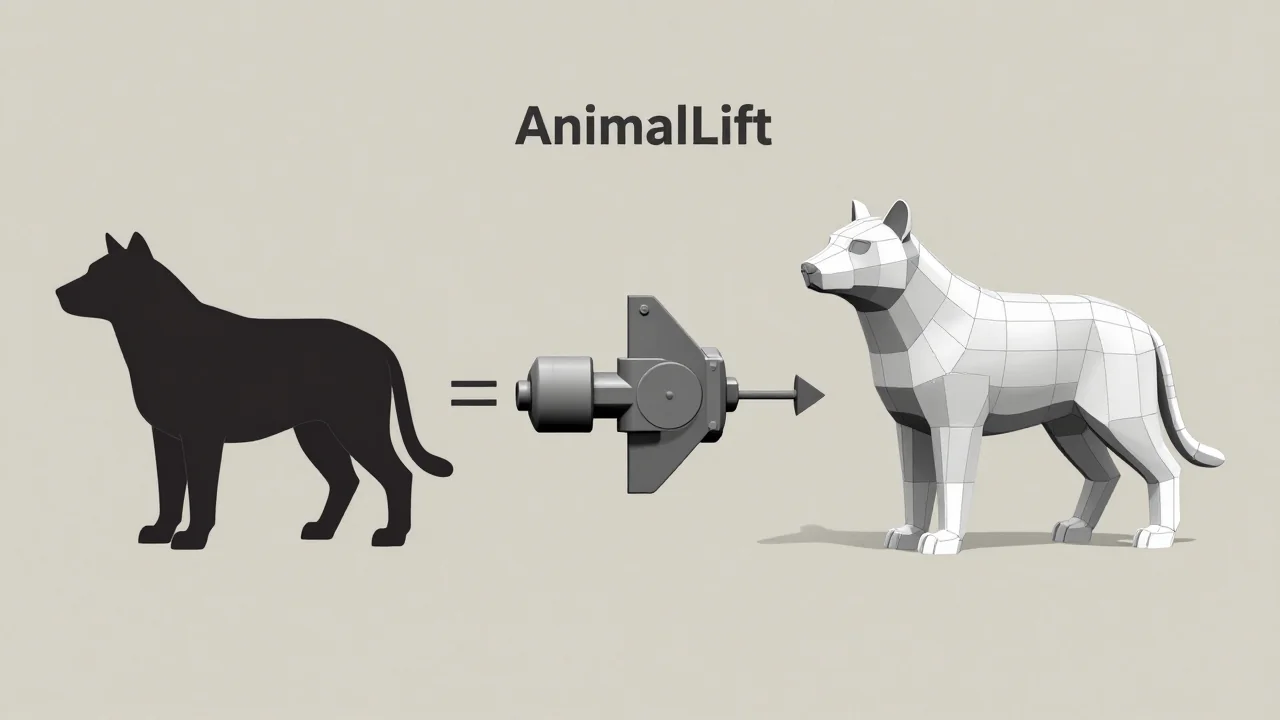
단일 이미지로부터 애니메이션이 가능하고 구조화된 3D 동물 모델을 복원하는 혁신적인 프레임워크 'AnimalLift'를 개발했습니다.
- 입력 이미지를 일관된 토폴로지와 UV 매개변수를 가진 공통 공간으로 변환하여 형태, 질감, 그리고 털 표현을 통합적으로 예측합니다.
- 단순한 복원을 넘어 애니메이션 제작, 포즈 전이(pose transfer), 털 편집 등 다양한 후속 작업에 바로 활용 가능한 구조화된 데이터를 제공합니다.
- 대규모 절차적 데이터셋으로 학습하여 애니메이션 및 시뮬레이션 환경에 적합하며 높은 일반화 성능을 입증했습니다.
단일 이미지로부터 완전히 애니메이션 가능한 3D 동물을 재구성하는 것은 어려운 과제이다. 애니메이션 준비가 된 에셋은 단순히 그럴듯한 지오메트리뿐만 아니라, 변형 및 시뮬레이션과 호환되는 통일된 토폴로지, 편집 가능한 외관, 그리고 털 표현이 필요하다. 기존의 이미지-3D 접근 방식들은 리깅이나 편집이 어려운 암묵적 또는 느슨하게 구조화된 표현에 의존하는 경향이 있었다.
AnimalLift는 단일 이미지로부터 명시적인 털을 포함한 구조화되고 애니메이션 호환성이 높은 3D 동물 에셋을 복원하는 프레임워크를 제시한다. 이 방법은 입력 이미지를 일관된 토폴로지와 UV 를 가진 공유 캐노니컬 공간으로 변환하여, 캐노니컬 지오메트리, 질감, 그리고 털을 통합적인 순방향 아키텍처에서 공동 예측하는 것이 특징이다. 특히, 메시 변형 및 털 시뮬레이션과 호환되는 명시적 털 복원을 가능하게 하는 UV 정렬된 털 맵이 핵심 구성 요소로 사용된다.
모델 학습을 위해 다양한 동물 종과 외모에 걸쳐 정렬된 지오메트리, 질감, 그리고 털을 제공하는 절차적 데이터 생성 파이프라인을 도입했다. 합성 및 실제 환경 데이터셋에서의 실험 결과는 높은 재구성 품질과 동물 카테고리를 아우르는 일반화 성능을 입증했다. 이 구조화된 표현은 애니메이션, 포즈 전이(pose transfer), 털 편집, 시뮬레이션 호환 렌더링 등 다양한 후속 응용 분야를 직접 지원한다.
용어 풀이
- 매개변수
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.