다중 스케일 질감 인식을 위한 계층적 비전 트랜스포머 아키텍처
HiPerViT: A Hierarchical Perceiver-Vision Transformer Architecture for Multi-Scale Texture Recognition
 arXiv
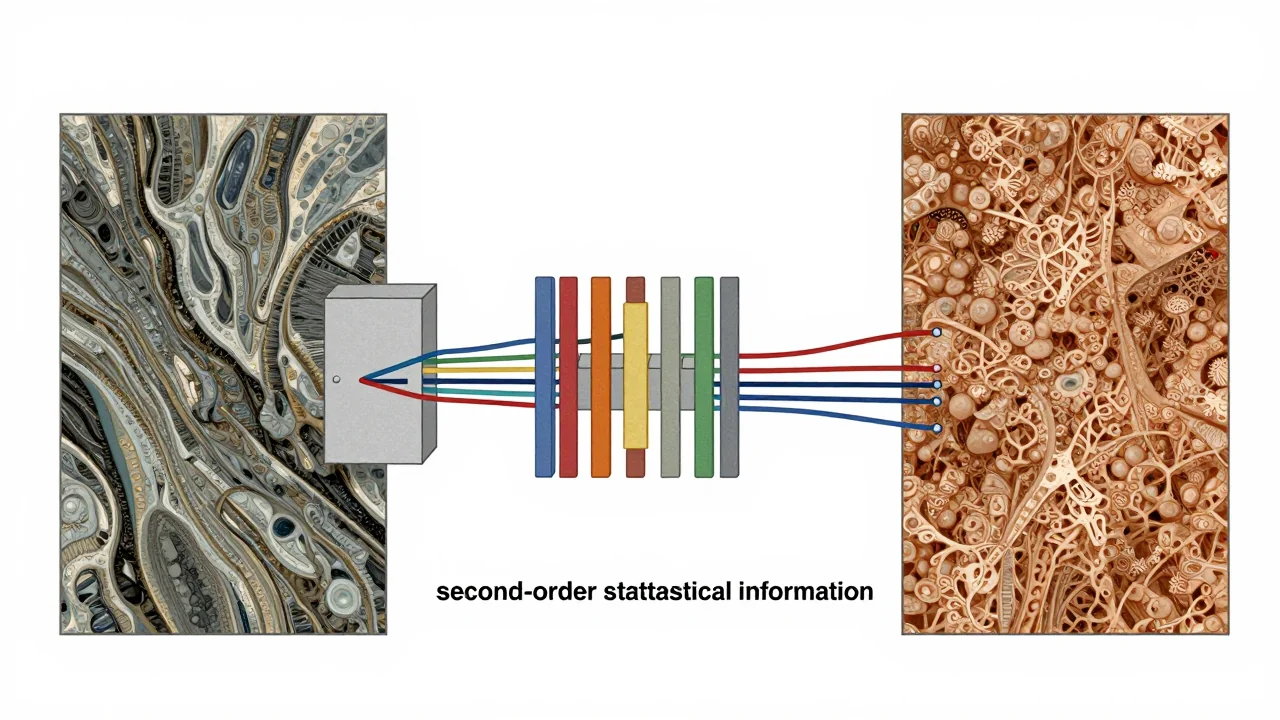
HiPerViT는 질감 인식이 어려운 문제를 해결하기 위해, 비전 트랜스포머에 명시적인 '2차 통계 정보'를 주입한 새로운 아키텍처입니다.
- 글로벌/로컬 이미지 뷰와 이진 선형 기술자를 통계적 토큰으로 결합하여, 공간 정보가 질감 특징과 직접 상호작용하도록 설계되었습니다.
- 다중 모드 학습이나 복잡한 구조 없이도, 미세 질감이 중요한 다양한 시각 인식 작업에서 높은 성능 향상을 입증했습니다.
- 성능 개선의 핵심은 특정 결합 방식이 아닌, 질감 관련 '2차 통계 정보'를 명시적으로 제공하는 것임을 보여줍니다.
질감 인식은 현대 비전 모델에게 어려운 과제인데, 이는 판별적인 증거가 단순히 객체 모양보다는 고차원 공간 통계에 의해 전달되는 경우가 많기 때문이다. 기존의 Vision Transformer는 강력한 장거리 모델링 능력을 제공하지만, 표준적인 객체 중심 표현 방식으로는 이러한 통계적 구조를 명시적으로 노출하지 못하여 미세 질감 인식 환경에서 한계가 있었다. 이에 HiPerViT는 비전 전용 아키텍처로, 기반의 인식 파이프라인에 명시적인 2차 통계 사전(prior)을 주입하는 방식을 제시했다.
이 방법은 글로벌 및 로컬 이미지 뷰와 컴팩트한 이진 선형 기술자(bilinear descriptor)를 통계적 으로 인코딩하여 결합한다. 또한, Perceiver 스타일의 잠재 디스틸레이션(latent )을 통해 이 토큰을 1차 공간 표현에 통합한다. 이러한 설계는 공간 토큰과 2차 특징 공동 발생 통계 간의 직접적인 상호작용을 가능하게 하여, 다중 모드 사전 학습이나 앙상블 구성 없이도 모델이 질감 관련 정보에 명시적으로 접근하도록 한다.
HiPerViT는 여섯 가지 질감 인식 에서 강력한 비전 전용 기준선 대비 일관된 성능 향상을 달성했다. 구체적으로 DTD에서 +3.05%p, GTOS-Mobile에서 +10.48%, 그리고 1200Tex에서 +10.10%의 개선을 보였다. 이러한 결과는 성능 향상의 주요 원인이 특정 융합 토폴로지가 아니라, 질감 관련 2차 통계 정보를 일급 표현 신호(first-class representational signal)로서 명시적으로 제공하는 것임을 시사한다.
용어 풀이
- 트랜스포머
- 오늘날 대부분의 언어 모델이 쓰는 신경망 구조. 문장 속 단어들의 관계를 한꺼번에 계산해요.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- distillation
- 큰 모델의 답을 작은 모델이 따라 배우게 해서 가볍고 빠른 모델을 만드는 방법.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.