이미지 데이터셋 분류기 선택을 위한 메타 학습 프레임워크
Meta-Learning for Classifier Selection in Image Datasets: A Feature-Driven Framework for Accuracy Prediction
 arXiv
이미지 데이터셋에 가장 적합한 분류기를 선택하는 것은 매우 어려운 과제입니다. 본 연구는 데이터 복잡도를 포착한 메타 특징을 활용하여 모델 성능을 예측하는 메타 학습 프레임워크를 제안했습니다.
- 이 방법은 방대한 훈련 없이도 분류기 성능을 효율적으로 추정하며, 56개 다양한 이미지 데이터셋에서 평균 순위 예측 정확도 86% 이상이라는 높은 성과를 입증했습니다.
- 모델 선택 과정에서 발생하는 막대한 계산 비용과 시간을 절약하고, 어떤 모델이 가장 효과적일지 사전에 판단할 수 있는 실용적인 솔루션을 제공합니다.
- 자연, 의료 영상 등 광범위한 개념을 아우르는 56개 데이터셋에 걸쳐 검증되어 높은 일반화 성능과 확장성을 입증했습니다.
본 연구는 이미지 데이터셋에 가장 적합한 분류기를 선택하는 것이 매우 어렵고 중요한 과제임을 전제로 합니다. 기존의 '무료 점심 이론(No Free Lunch theorem)'에 따르면, 특정 분포에서 얻은 성능 향상은 모든 문제 집합에 걸쳐 성능 손실을 초래할 수 있어 단일 모델이 보편적으로 최적일 수 없습니다. 이에 본 논문은 데이터셋 복잡도를 포착하는 종합적인 메타 특징을 활용하여 분류기 성능을 예측하는 메타 학습 프레임워크를 제안했습니다.
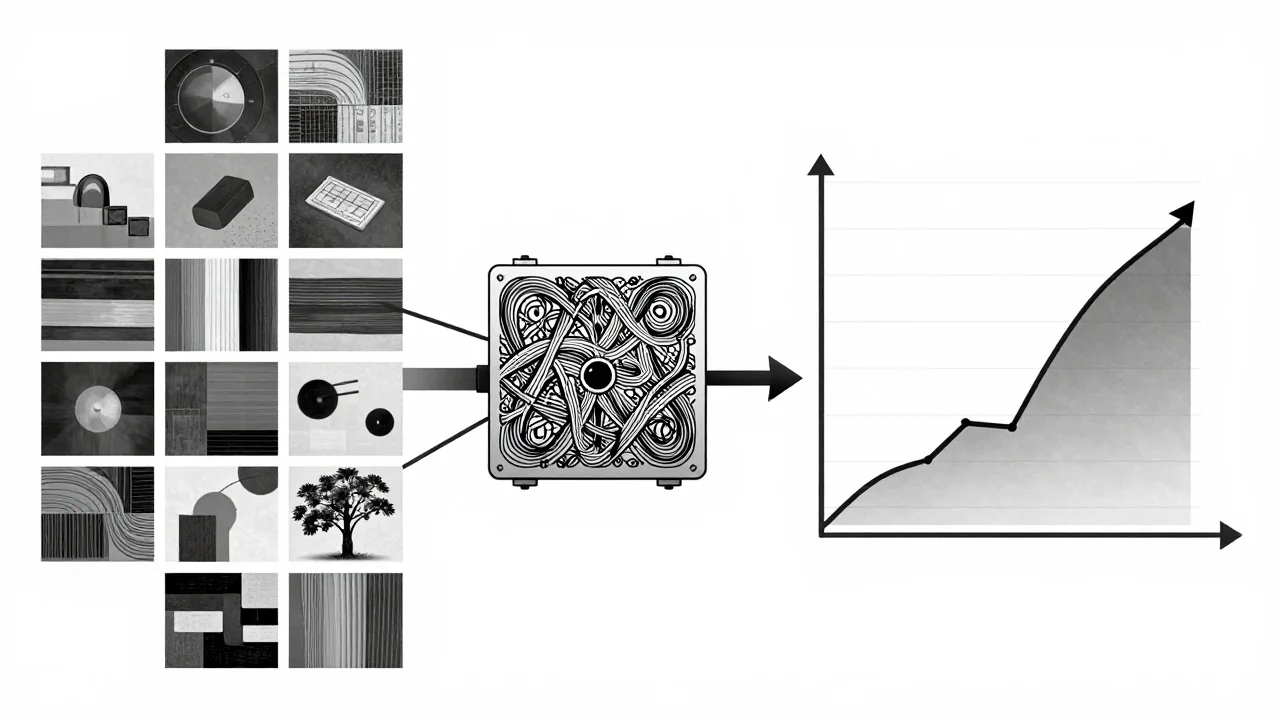
제안된 방법론에서는 오토인코더, 사전 훈련 네트워크 및 차원 축소 기법과 같은 방법을 사용하여 특징을 추출하고 선택합니다. 이렇게 얻은 특징들을 바탕으로 회귀 모델을 훈련시켜 분류기 정확도를 효율적으로 추정할 수 있습니다. 또한, 유사한 성능 패턴을 가진 분류기들을 그룹화하기 위해 클러스터링 기술이 사용되어 추천 과정을 단순화했습니다.
본 프레임워크는 자연, 동물, 의료 영상 등 광범위한 개념을 포함하는 56개의 다양한 이미지 데이터셋에 걸쳐 평가되었습니다. 그 결과, 평균 순위 예측 정확도가 86%를 초과하는 높은 성능을 달성하며 효과성을 입증했습니다. 이 방법은 모델 선택 과정에서 발생하는 계산 비용을 줄이고 분류 성능을 개선할 수 있는 실용적이고 해석 가능한 솔루션을 제공합니다.