리서치 연구
멀티모달 LLM의 메모리 효율을 높이는 OmniKVQuant 기술
OmniKVQuant: KV Cache Quantization for Omni-LLMs
 arXiv
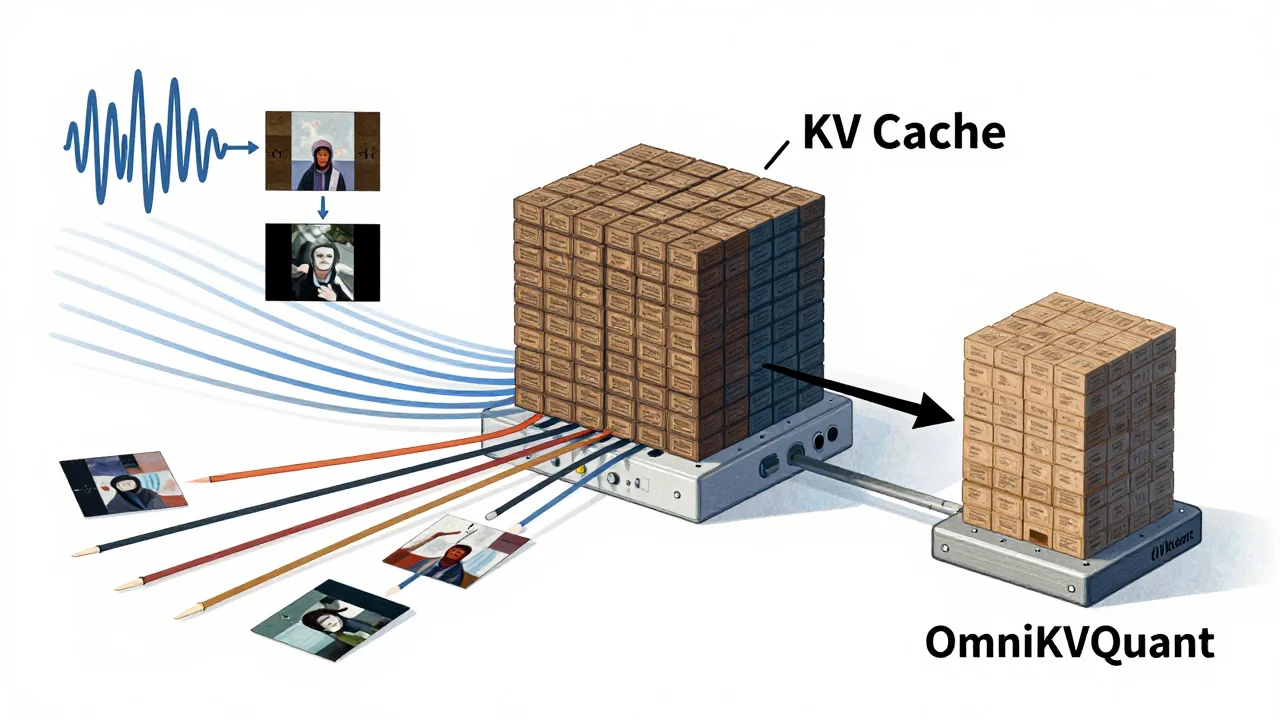
멀티모달 LLM이 오디오, 비디오 등 여러 모달리티를 처리하며 발생하는 막대한 KV 캐시 메모리 부담을 줄이기 위해 'OmniKVQuant'라는 새로운 양자화 기법이 개발되었습니다.
세 줄 요약
- 이 방법은 입력 스트림 창마다 키 양자화 범위를 설정하고 모달리티별로 값을 분리 회전시켜, 7개 오디오-비주얼 벤치마크에서 성능을 유지하며 2비트 캐시를 구현했습니다.
- 메모리 사용량을 획기적으로 줄여 초대형 멀티모달 언어 모델(Omni-LLMs)의 경량화와 실제 장치에서의 효율적인 배포를 가속화할 수 있습니다.
- 특히, 어텐션 과정에서 고밀도 FP16 캐시 생성을 막고 2비트 캐시를 해제하는 통합 트라이톤 커널을 제공하여 구현 효율성이 높습니다.
멀티모달 LLM이 오디오, 비디오 등 여러 모달리티를 처리하며 발생하는 막대한 KV 캐시 메모리 부담을 줄이기 위해 'OmniKVQuant'라는 새로운 양자화 기법이 개발되었습니다.