리서치 연구
LLM의 도메인별 환각 탐지 및 성능 개선 연구
Domain-Specific Hallucination Detection in Large Language Models
 arXiv
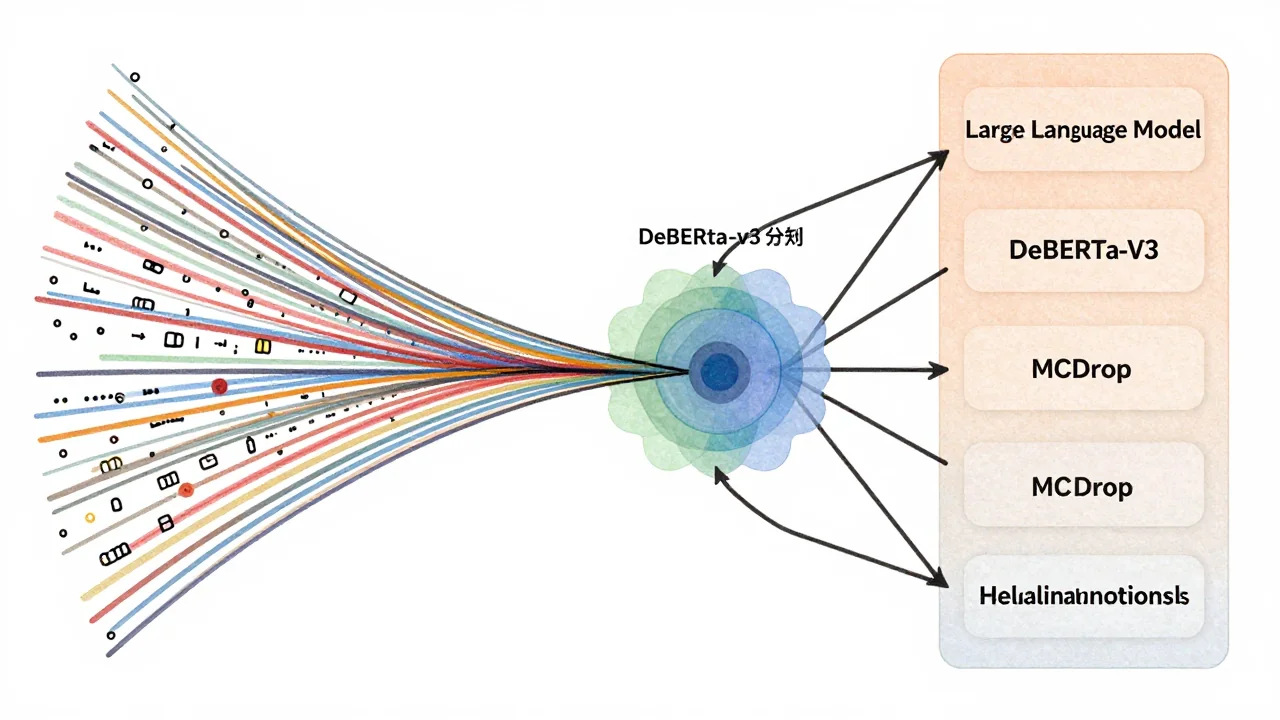
연구진은 LLM의 환각(Hallucination) 탐지를 위해 DeBERTa-v3 분류, MC Dropout 등 여러 신호를 결합한 다중 파이프라인을 개발했습니다.
세 줄 요약
- 이 방법론은 일반 영역에서 높은 탐지 성능을 보였으며, DPO 기법 적용 시 LLM의 환각률을 85.5%에서 37.7%로 크게 낮추는 성과를 입증했습니다.
- 환각 현상은 단순히 모델 자체의 문제가 아닌 도메인 지식 부족에서 비롯되므로, 신뢰성 확보를 위해 도메인별 미세 조정이 필수적임을 시사합니다.
- 따라서 일반 학습만으로는 성능 저하가 크기 때문에, 과학(SciFact)처럼 특정 분야 데이터를 활용한 사전 훈련이 가장 강력한 적응 전략입니다.
연구진은 (LLM)이 생성하는 유창하지만 부정확한 주장, 즉 '(hallucination)' 현상을 탐지하기 위한 다중 신호 파이프라인을 제시했습니다. 이 방법론은 된 DeBERTa-v3 분류기, 몬테카를로(MC) 드롭아웃 불확실성 정량화, 온도 스케일 보정 등을 결합하여 응답 수준의 환각 탐지를 수행합니다. 일반 영역 테스트에서 F1=0.915와 AUROC=0.977을 달성했으며, 추가적으로 Direct Preference Optimization (DPO) 기법을 적용하여 LLM의 환각률을 85.5%에서 37.7%로 낮추는 성과를 보였습니다.
연구 결과에 따르면 일반 영역에서의 학습만으로는 성능 전이가 미흡하며(F1=0.52), 신뢰성 확보를 위해서는 도메인별 미세 조정이 필수적입니다. 특히, 과학 분야의 SciFact 와 같은 특정 도메인을 활용한 사전 훈련이 가장 강력한 적응 전략임을 입증했습니다. PubMedBERT 모델을 SciFact에 미세 조정했을 때 F1=0.63 및 AUROC=0.81을 달성하며, 도메인 매칭 기반의 전처리 과정이 중요함을 보여주었습니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 환각
- AI가 사실이 아닌 내용을 그럴듯하게 지어내는 현상.
- 미세 조정
- 이미 학습된 모델을 특정 목적의 데이터로 조금 더 학습시키는 일.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.