리서치 연구
기업 환경을 위한 현실적인 질의응답 평가 파이프라인 'WinSyn'
WinSyn: An Automated Pipeline for Realistic Enterprise Question-Answering Evaluation
 arXiv
기업 환경의 복잡한 QA 평가를 위해, 현실적인 시나리오 기반 합성 데이터 생성 파이프라인 'WinSyn'을 개발했습니다.
세 줄 요약
- 이 데이터는 수개월에 걸친 다수 직원의 상호작용을 시뮬레이션하며, 분산되고 모호한 기업 정보를 반영하여 높은 난이도를 구현했습니다.
- 기존의 단순한 벤치마크로는 실제 업무 환경에서 발생하는 복잡하고 분산된 정보 처리 능력을 제대로 검증하기 어렵다는 점을 보여줍니다.
- 테스트 결과 에이전트들의 평균 점수가 80% 미만에 그쳐, 실무에 적용 가능한 강력한 AI 시스템을 위해서는 현실적인 평가 데이터가 필수적임을 시사합니다.
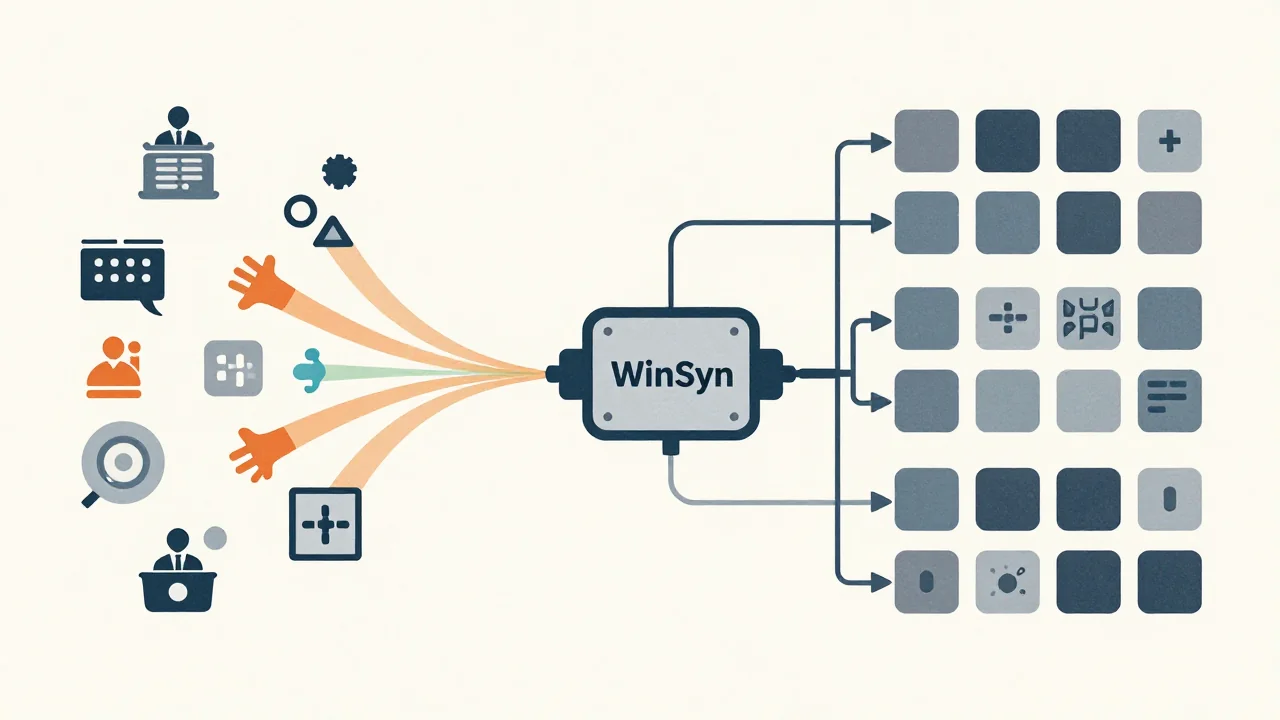
기존의 질문 응답(QA) 는 실제 기업 환경의 복잡성을 반영하기 어렵다는 한계가 있습니다. 기업 데이터는 이메일, 채팅 메시지, 문서 등 다양한 아티팩트에 걸쳐 분산되어 있고 충돌 가능성이 높아 난이도가 높습니다. 본 연구에서는 이러한 현실적인 업무 시나리오를 반영하여 를 생성하는 자동화된 파이프라인인 'WinSyn'을 소개합니다.
WinSyn은 수개월에 걸친 장기 기업 프로젝트를 시뮬레이션하며, 최대 25명의 직원이 여러 역할을 맡아 상호작용하는 상황을 구현합니다. 이 데이터셋은 모호성(ambiguity), 분산된 정보 처리, 그리고 자연적으로 발생하는 질의 유형을 강조하여 실제 업무 환경의 복잡성을 높였습니다.
개발된 파이프라인을 검증하기 위해 몇 가지 표준 기반 베이스라인 모델들을 테스트한 결과, 모든 쿼리에서 평균 점수가 80% 미만에 그치는 것으로 나타났습니다. 이는 기업 시스템에 적용 가능한 강력한 AI를 개발하려면 현실적이고 높은 복잡성을 가진 평가 데이터가 필수적임을 시사합니다.
용어 풀이
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.
- 합성 데이터
- 실제로 모은 것이 아니라 AI나 프로그램으로 만들어 낸 학습용 데이터.
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.