장기 대화 기억을 위한 단서 기반 문맥 재구성 프레임워크(CueMem)
CueMem: Cue-Guided Context Reconstruction for Long-Term Conversational Memory
 arXiv
장기 대화 기억의 정보 과부하 문제를 해결하기 위해, CueMem은 추출된 '단서(Cue)'를 활용하여 질문에 필요한 문맥을 재구성하는 새로운 프레임워크입니다.
- 이 방식은 단서를 원본 대화 기록과 연결하고 그래프 구조로 확장하며, 이를 통해 성능은 유지하면서 입력 토큰 사용량과 지연 시간을 크게 줄였습니다.
- LLM 기반 에이전트가 방대한 과거 기록 속에서도 중요한 근거를 놓치지 않고 정확하게 답변할 수 있는 신뢰성 높은 기반을 마련했다는 점에서 의미가 큽니다.
- 핵심은 전체 대화 기록을 사용하는 것이 아니라, 검색된 단서를 바탕으로 문맥을 재구성하는 접근법이며, 따라서 단서 추출의 정확도가 중요합니다.
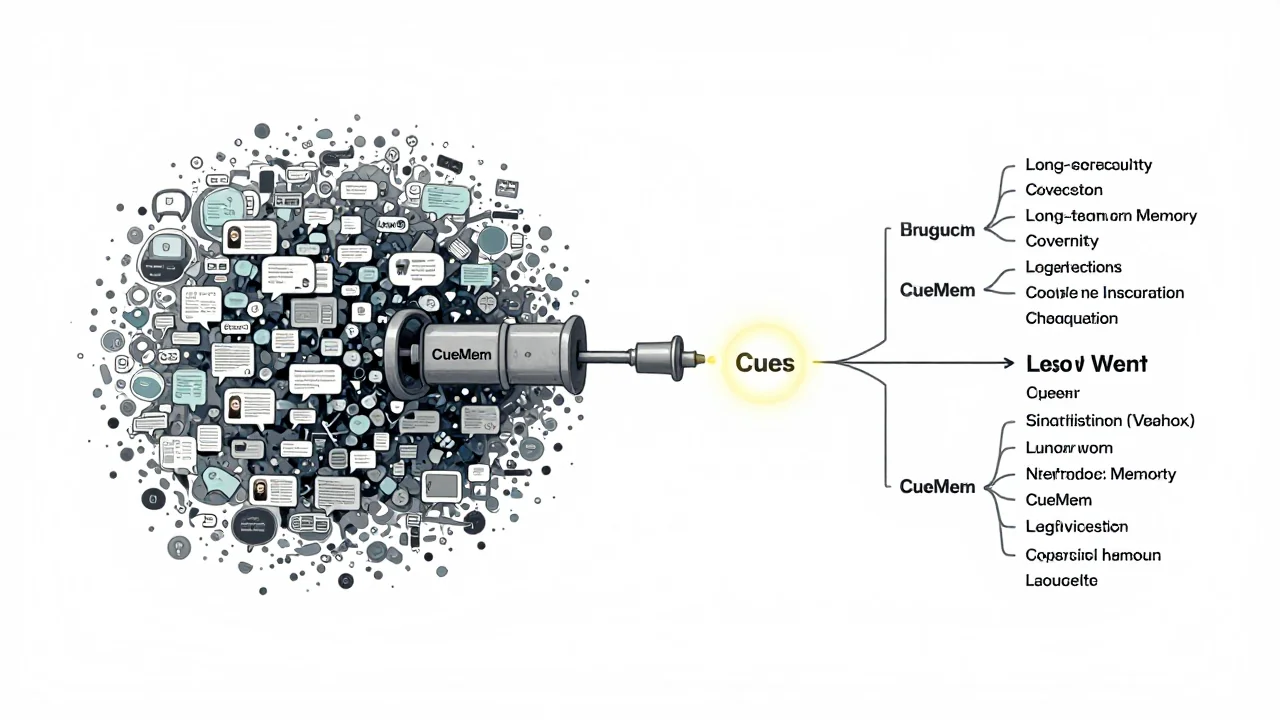
장기적인 대화 가 방대한 대화 기록에서 정보를 검색하여 답변하려면, 전체 대화 기록을 사용하는 것은 비용이 많이 들고 신뢰성이 떨어지는 문제가 있습니다. 또한, 메모리를 압축할 경우 질문 응답에 필요한 미세한 증거(fine-grained evidence)를 잃을 수 있습니다. CueMem은 자전적 기억의 재구성 관점에서 영감을 받아 개발된 프레임워크로, 추출된 메모리 기록 자체를 독립적인 증거가 아닌 검색 단서(retrieval cues)로 간주하여 질문과 관련된 대화 문맥을 원본 턴에서 재구성합니다.
CueMem은 기억 구축 단계에서 대화 턴으로부터 미세한 메모리 단서를 추출하고 각 단서를 해당 출처 턴에 연결합니다. 질의 시점에는 질문 관련 단서들을 검색하여 이를 출처 턴 앵커(source-turn anchors)에 매핑합니다. 이후 시간적 근접성과 의미적 연관성을 포착하는 턴 그래프 위에서 확장함으로써, 원본 대화 기록으로부터 답변 생성을 위한 간결한 증거 문맥을 재구성할 수 있습니다.
실험 결과에 따르면 CueMem은 LoCoMo와 LongMemEval 등 대표적인 장기 기억 기준 모델들을 일관되게 능가하는 성능을 보였습니다. 특히, 전체 대화 기록을 사용하는 방식과 비교했을 때도 입력 사용량과 지연 시간을 줄이면서 필요한 대화 증거를 성공적으로 복구했습니다. 이는 검색 단서(retrieval cues)가 장기적인 대화 질문 응답에 있어 독립적인 메모리 증거의 효과적인 대안임을 보여줍니다.
용어 풀이
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.