비전 백본 비교: 나무 분할 및 스테레오 깊이 측정 연구
What Does the Encoder Actually Decide? A Controlled Comparison of Vision Backbones on Joint Tree Segmentation and Stereo Depth
 arXiv
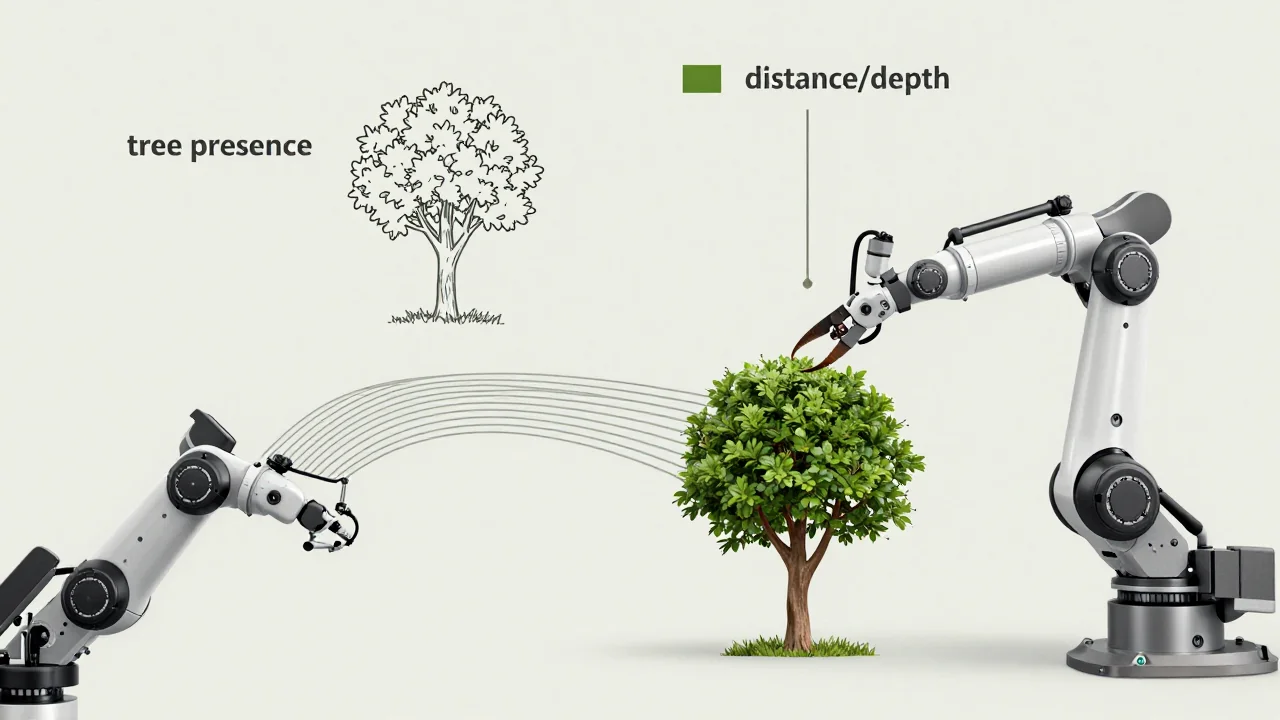
로봇이 나무를 가지치기 하려면 '나무 여부'와 '거리(깊이)'라는 두 정보를 동시에 알아야 합니다. 본 연구는 여러 비전 인코더(CNN, 트랜스포머 등)의 교체를 통해 이 복합 작업에서의 성능 변화를 측정했습니다.
- 가장 강력한 성능을 보인 것은 최신 트랜스포머보다 CNN이나 하이브리드 구조였으며, 파라미터 크기보다는 효율적이고 안정적인 설계가 우수한 결과를 가져옴을 입증했습니다.
- 이는 복잡한 환경 인식 작업에서 단순히 거대한 모델이나 최신 아키텍처만이 정답이 아니며, 계산 효율성과 구조적 안정성이 핵심임을 시사합니다.
- 모델 평가 시 '모든 픽셀이 나무'로 오인하는 퇴화 현상에 주의해야 하며, 경계선(Boundary F1) 등 다양한 지표를 활용하여 모델의 신뢰성을 검증할 필요가 있습니다.
로봇의 가지치기 작업을 위해서는 픽셀별로 해당 부분이 나무에 속하는지 여부와 거리를 동시에 파악해야 합니다. 본 연구는 데이터셋, 디코더, 손실 함수, 스케줄링을 고정하고 오직 비전 인코더만 교체하여, 얇은 식물군에서의 공동 의미론적 분할 및 스테레오 깊이 측정 성능 변화를 분석했습니다.
다양한 아키텍처(CNN, , 하이브리드 등)의 [N]개 인코더를 구축하고 학습시킨 결과, 가장 강력한 성능을 보인 것은 CNN이나 하이브리드 구조였으며, 일부 일반 비전 트랜스포머는 학습 과정에서 붕괴되는 현상이 관찰되었습니다. 또한, 개수가 모델의 품질을 예측하지 못하며, [P]M 개의 작은 인코더가 훨씬 큰 모델보다 우수한 성능을 보였습니다.
연구 결과에 따르면, 분할과 깊이 측정 순위는 강하게 일치하는 경향(Spearman $\rho$ = [RhoValue])을 보여 두 작업 간의 충돌은 없음을 입증했습니다. 다만, 일부 인코더([K] of [N])는 모든 픽셀을 나무로 오인하는 퇴화 현상을 보일 수 있어, 경계 F1 점수 등 다양한 지표를 활용한 신뢰성 검증이 필요합니다.
용어 풀이
- 트랜스포머
- 오늘날 대부분의 언어 모델이 쓰는 신경망 구조. 문장 속 단어들의 관계를 한꺼번에 계산해요.
- 파라미터
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.