LLM 심사관을 활용한 전문 특허 초안 작성 에이전트 평가 연구
Vibe Patenting: Evaluating LLM Judges for Professional Patent-Drafting Agents
 arXiv
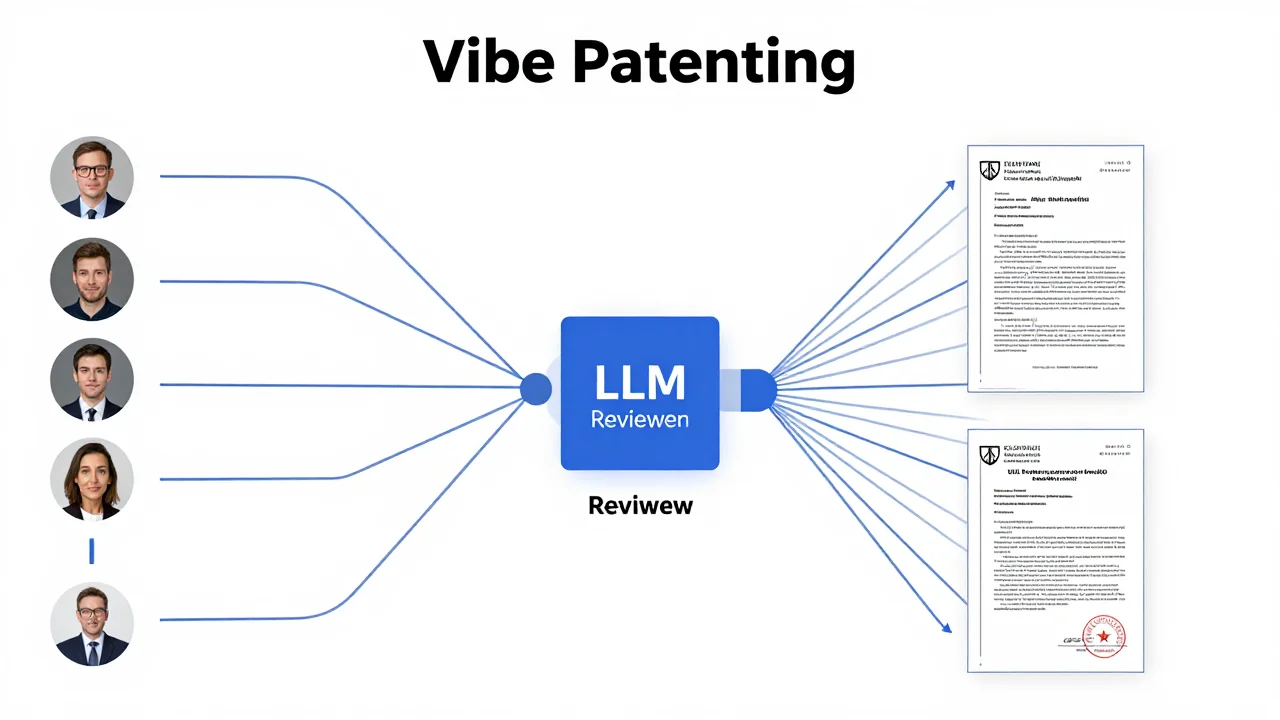
연구진은 LLM 심사관을 활용하여 AI 에이전트의 특허 초안 작성 성능을 평가하는 'Vibe Patenting' 테스트베드를 구축하고 그 유효성을 검증했습니다.
- 심사관의 피드백 기반 반복 수정 과정은 품질 향상에 효과적이며, 낮은 추론 능력을 가진 에이전트도 고성능 수준에 근접할 수 있음을 입증했습니다.
- 이는 특허 작성 같은 전문 영역에서 LLM 심사관이 단순 검토를 넘어 성능 최적화의 중요한 지표로 활용될 수 있음을 시사합니다.
- 다만, LLM 심사관 평가는 전문 변리사의 평가와 비교했을 때 사용된 측정 기준(metric)에 따라 결과가 크게 달라지는 한계점을 가집니다.
연구진은 의 성능을 평가하기 위해 'Vibe Patenting'이라는 종단 간(end-to-end) 테스트베드를 구축했습니다. 이 시스템에서는 별도로 호출된 심사관이 생성된 특허 초안을 평가하고, 반복적인 수정을 위한 구조화된 피드백을 제공합니다. 이는 복잡한 전문 작업에 사용되는 AI 에이전트의 신뢰성을 검증하는 것을 목표로 합니다.
다수의 발명과 작성 에이전트 구성을 통해 테스트한 결과, 심사관의 피드백 기반 반복 수정 과정은 평가된 품질을 지속적으로 향상시키는 것으로 나타났습니다. 특히 주목할 점은, 이러한 반복적인 심사관의 피드백 덕분에 추론 능력이 낮은(low-reasoning) 에이전트가 훨씬 더 비용이 많이 드는 고추론(high-reasoning) 에이전트 수준의 성능에 근접할 수 있다는 것입니다. 또한, 강력한 모델과 도메인 특화된 에이전트 워크플로우가 추가적인 성능 향상을 제공하는 것으로 확인되었습니다.
LLM 심사관을 독립적으로 평가하기 위해 전문 변리사의 평가와 비교했을 때, 결과는 의미 있는 수준의 일치도를 보였으나 이는 사용된 측정 기준(metric)에 크게 의존하며 체계적인 교정 차이점도 발견되었습니다. 이러한 연구 결과는 LLM 심사관이 복잡한 전문 워크플로우에서 평가 도구이자 성능 최적화 신호로 활용될 수 있는 유용성을 보여주지만, 동시에 그 한계점 또한 명확히 제시합니다.
용어 풀이
- AI 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.