그래픽스 기반 연속 LOD 학습을 활용한 이미지 복원 기술
GraLoD: Graphics-Inspired Continuous Level-of-Detail Learning for Image Restoration
 arXiv
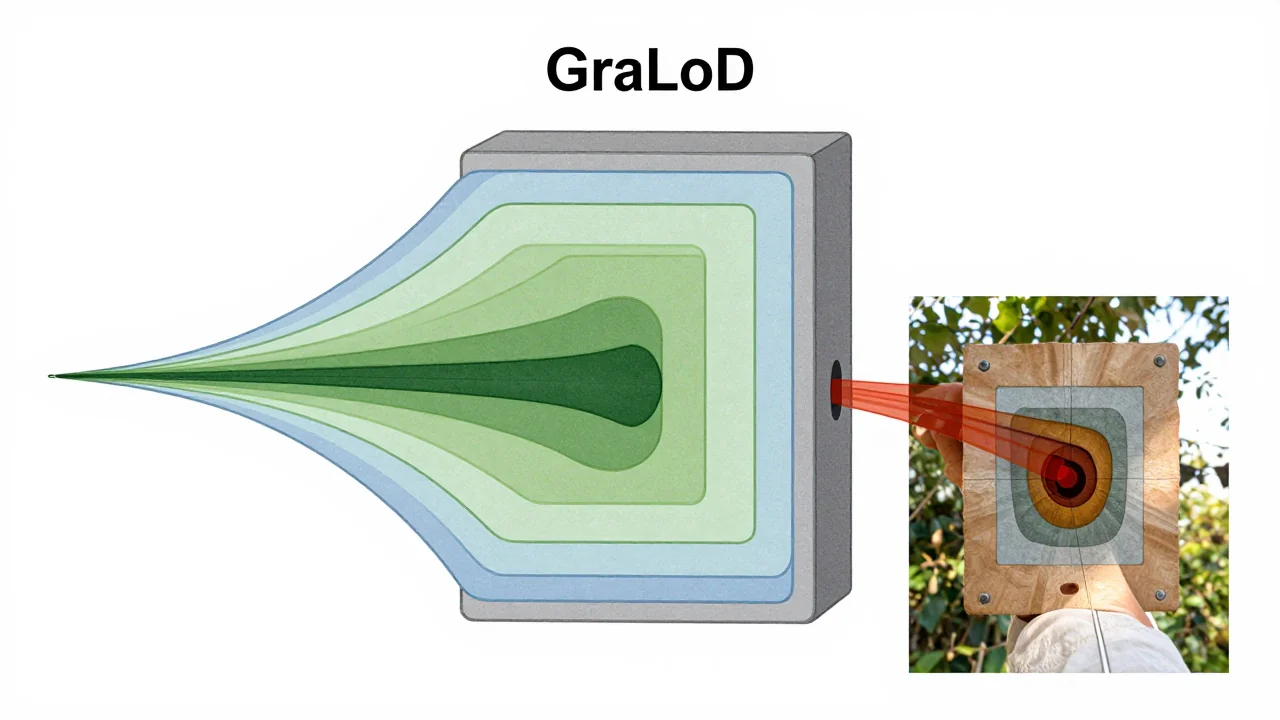
기존 이미지 복원 모델이 고정된 다중 스케일 구조에 의존하는 한계를 극복하기 위해, 그래픽스 분야의 LOD 개념을 차용한 GraLoD가 제안되었습니다.
- GraLoD는 복원 스케일을 공간적/단계별 연속 변수로 취급하여, 각 위치가 주변 레벨만 쿼리하며 지역 콘텐츠에 맞춰 최적화된 스케일을 능동적으로 조정합니다.
- 기존 모델 구조를 변경할 필요 없이 플러그 앤 플레이 방식으로 통합 가능하며, 다양한 복원 환경에서 일관되고 높은 성능 향상을 입증한 것이 핵심 강점입니다.
- 효과적이면서도 공간적 일관성을 보장하기 위해 최소 충분 영역 보정(MSFC) 및 구조 인식 정규화(SAR) 같은 안정화 기술을 추가 적용했습니다.
기존의 이미지 복원 방법들은 고정된 다중 스케일 계층 구조에 의존하여, 필요한 공간적 지원 범위가 복원 유형이나 지역별로 달라지는 문제를 해결하기 어려웠습니다. 이러한 한계를 극복하고자 그래픽스 분야의 레벨-오브-디테일(LOD) 렌더링 개념에서 영감을 받은 GraLoD 프레임워크가 제안되었습니다. GraLoD는 복원 스케일을 공간적으로 변화하며 단계에 따라 달라지는 연속 변수로 취급합니다.
GraLoD는 기존 인코더 계층을 재사용하고, 다중 스케일 특징들을 공유된 LOD 표현 공간으로 정렬하는 것이 핵심입니다. 각 디코더 단계에서 스테이지 조건이 부여된 LOD 필드를 예측하며, 이를 통해 특정 공간 위치가 주변의 두 가지 레벨만 연속적으로 쿼리할 수 있게 됩니다. 이 방식은 효과적인 복원 스케일이 지역 이미지 콘텐츠와 복원 진행 상황 모두에 적응하도록 합니다.
또한 GraLoD는 안정성을 높이기 위해 최소 충분 영역 보정(MSFC)과 구조 인식 정규화(SAR)를 도입하여, 복원에 효과적이면서도 공간적으로 일관된 LOD 할당을 장려합니다. 이 프레임워크는 기존의 복원 백본에 재설계 없이 플러그 앤 플레이 방식으로 직접 통합될 수 있으며, 다양한 작업별 및 올인원 복원 환경에서 성능 개선을 입증했습니다.