FLAT: 이미지와 텍스트를 통합하는 멀티모달 표현 학습 프레임워크
FLAT: Resampling Image and Text into 1D Flexible-Length Aligned Transmodal Tokens for Retrieval and Generation
 arXiv
기존 멀티모달 모델의 인코딩과 생성 과정이 분리되어 성능 병목을 겪던 문제를 해결하기 위해, FLAT은 이미지와 텍스트를 하나의 연속적인 1D 공간에 통합하는 새로운 프레임워크입니다.
- FLAT은 공유된 멀티모달 인코더와 T2I/I2T 디코더를 공동 최적화하며, 이를 통해 텍스트-이미지 생성 및 검색에서 최고 수준의 성능을 달성합니다.
- 단순한 데이터 인식 단계를 넘어, FLAT은 잠재 공간 연산이나 선형 보간 등 복합적인 추론이 가능한 기반을 마련했다는 점에서 큰 의미가 있습니다.
- 본 프레임워크는 범용적인 사전 학습으로 다양한 변수 길이의 검색 및 생성을 지원하며, 실제 목적에 맞춰 미세 조정(fine-tuning)하여 활용할 수 있습니다.
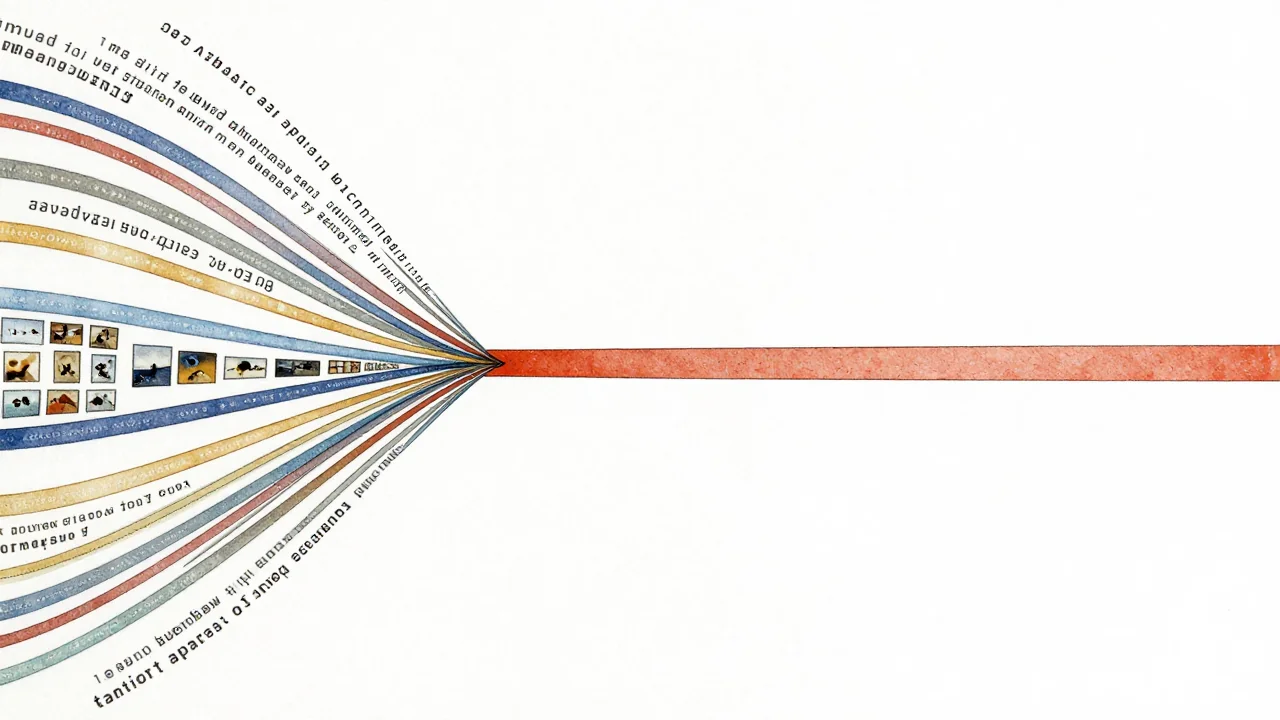
기존의 표현 학습 및 생성 과정은 인코딩과 생성이 분리되어 있어, 고정된 으로 인해 생성 성능에 병목 현상이 발생했습니다. FLAT(Flexible-Length Aligned Transmodal representations)는 이러한 간극을 해소하기 위해 공동의 멀티모달 인코더와 다운스트림 텍스트-이미지(T2I) 및 이미지-텍스트(I2T) 디코더를 함께 최적화하는 사전 학습 프레임워크입니다. 이는 대비 정렬과 양방향 교차 모드 생성 목표를 결합하여, 표현이 판별적인 의미 기술자 역할과 생성 조건 역할을 동시에 수행하도록 합니다.
FLAT은 시각 및 텍스트 입력을 통합된 연속적인 1D 시퀀스 공간으로 매핑하는 구조적 특징을 가집니다. 이 프레임워크는 접두사-K 에 중첩 드롭아웃을 적용하여 동적인 출력 길이를 구현합니다. 단일 사전 학습 단계만으로도 FLAT은 가변적인 접두사 K를 통해 교차 모드 검색과 생성을 수행할 수 있습니다.
성능 평가 결과, FLAT은 T2I 생성에서 71.1 GenEval 점수를 달성했으며, 특정 작업 (fine-tuning)을 거치면 T2I 생성에서 83.1 GenEval을 기록했습니다. 또한 MS-COCO 이미지 캡셔닝에서는 40.5 BLEU-4 및 138.6 CIDEr를 보였으며, Flickr30K 데이터셋에서는 I2T(98.3)와 T2I(93.6)에서 높은 Recall@5 점수를 기록하는 등 우수한 성능을 입증했습니다.
용어 풀이
- 멀티모달
- 글뿐 아니라 이미지·음성·영상처럼 여러 형태의 입력을 함께 다루는 것.
- 임베딩
- 글이나 이미지의 의미를 숫자 목록으로 바꾼 것. 의미가 비슷한 것을 찾을 때 써요.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- 미세 조정
- 이미 학습된 모델을 특정 목적의 데이터로 조금 더 학습시키는 일.