리서치 연구
실수에서 배우는 반성적 회복: LLM 추론 능력 향상 방법론
Reflective Recovery: A Self-Supervised Method for Reasoning by Learning from Mistakes
 arXiv
LLM의 추론 과정에서 발생한 실패 사례를 역으로 학습 데이터로 활용하는 'Reflective Recovery'라는 자기 지도 방식이 개발되었습니다.
세 줄 요약
- 이 기법은 외부 평가자나 보상 모델 없이도 모델 스스로 오류를 감지하고 수정하며, 기존의 한계였던 스케일링 붕괴 문제를 극복합니다.
- 이는 단순히 정답을 암기하는 결과 중심 학습에서 벗어나, 추론 과정을 되돌아보고 개선하는 '반성적 사고'가 가능한 패러다임 전환을 의미합니다.
- 실제 벤치마크 테스트를 통해 높은 성능 향상을 입증하며, LLM의 지능형 문제 해결 능력을 한 단계 끌어올린 중요한 방법론으로 주목받고 있습니다.
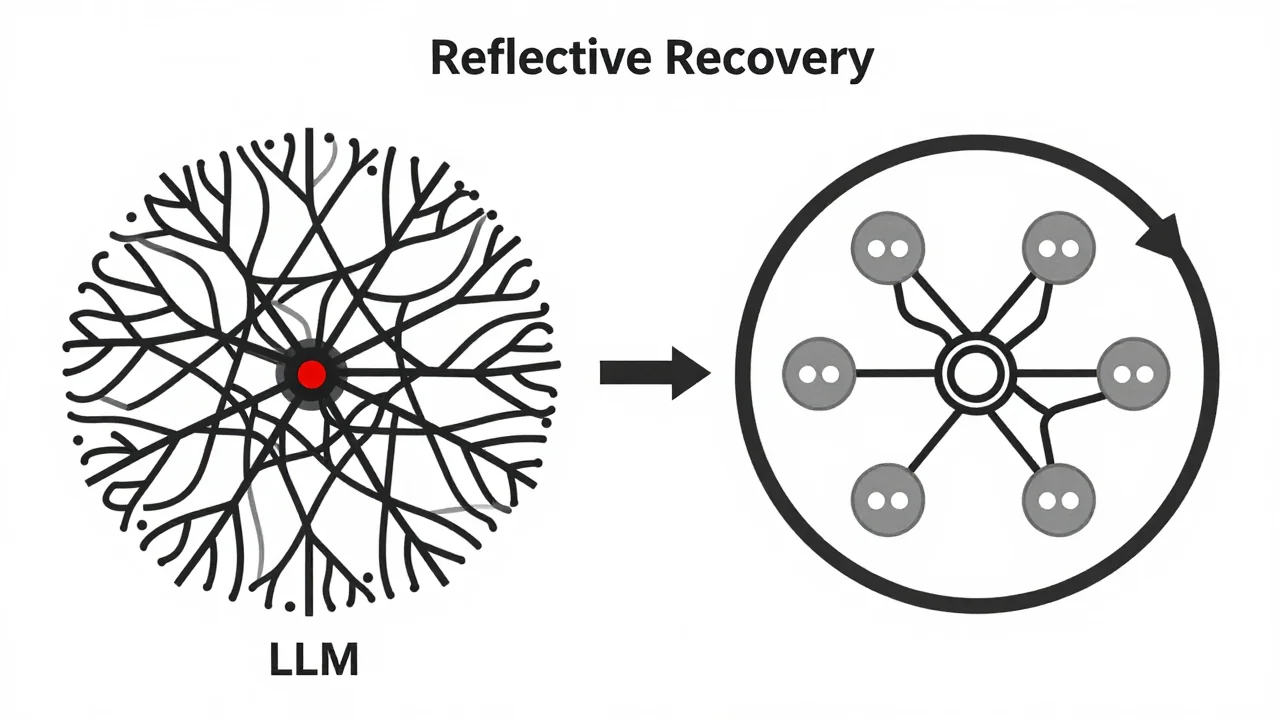
기존의 (LLMs) 추론 능력 강화 방식은 완벽한 추론 궤적에 의존하는 모방 학습이 주류였으나, 문제 세트가 제한될 경우 성능 개선에 한계(Scaling Collapse)를 보였습니다. 이에 연구진은 실패한 추론 시도 자체를 회복 학습 데이터로 활용하는 자기 지도 방식인 'Reflective Recovery'를 제안했습니다.
이 방법은 실패한 추론 과정의 초기 세그먼트를 추출하고 와 결합하여 LLM을 유효한 솔루션으로 안내합니다. 이 과정을 통해 모델은 외부 비평가나 보상 모델에 의존하지 않고도 오류를 인식하고 수정하는 방법을 학습하며, 잘못된 상태에서도 회복할 수 있게 됩니다.
광범위한 테스트에서 성능 향상이 입증되었습니다. DeepSeek-R1-Distill-Qwen-7B 모델을 대상으로 AIME 2025에서는 정확도가 30.0%에서 37.5%로, Minerva에서는 37.6%에서 47.8%로 상승했습니다. 이는 단순히 정답을 암기하는 결과 중심 학습을 넘어선 과정 중심의 반성적 추론이 가능함을 보여주며 스케일링 붕괴 장벽을 극복하는 패러다임 전환으로 평가됩니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 프롬프트
- AI에게 주는 지시나 질문 글.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.