긴 문맥 확산 언어 모델 학습을 위한 블록 병렬화 기술
Block Parallelism For Efficient Distributed Long-Context Diffusion Language Model Training
 arXiv
대규모 확산 언어 모델(BDLM)의 긴 문맥 학습 시 발생하는 메모리 및 통신 병목 현상을 해결하는 '컨텍스트-샤딩 블록 병렬화(CSBP)' 기술을 제안합니다.
- CSBP는 공유 시퀀스를 샤딩하고 블록 계산을 분산하여 메모리 중복을 제거하며, 최대 100만 토큰 컨텍스트에서 기존 대비 7배 이상의 속도 향상을 달성했습니다.
- 이 기술은 AI 모델이 훨씬 더 길고 복잡한 문맥 정보를 놓치지 않고 처리하게 하여, 실제 산업 응용 분야의 성능과 신뢰성을 혁신적으로 높일 잠재력을 가집니다.
- CSBP는 기존 블록 병렬화(BP)를 확장한 개념이며, 최대 성능을 위해서는 H100 같은 고성능 GPU 자원 및 분산 컴퓨팅 환경 구축이 필수적입니다.
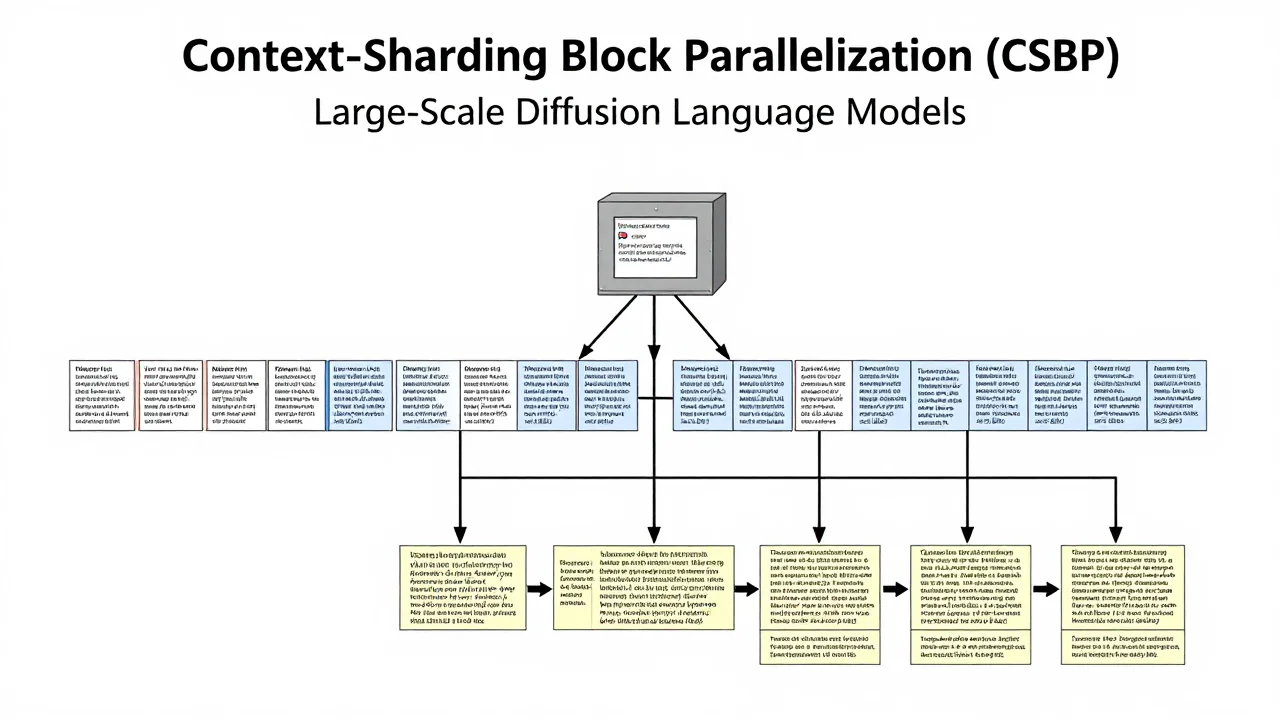
블록 확산 언어 모델(BDLMs)은 블록 간의 자기회귀적 의존성과 블록 내의 병렬 디노이징을 결합합니다. 그러나 긴 컨텍스트 학습 과정에서는 분산 어텐션 통신 및 활성화 메모리가 제약 요인으로 작용합니다. 연구진은 새로운 분산 병렬화 차원인 컨텍스트-샤딩 블록 병렬화(CSBP)를 도입했습니다. CSBP는 공유된 클린 시퀀스를 랭크별로 샤딩하여, 오염된 K/V와 그 기울기를 로컬하게 유지하고 중복되는 클린 접두사를 방지하면서 BDLM의 학습 의미론을 보존합니다.
CSBP를 적용한 결과, 16개의 H200 환경에서 256K 컨텍스트를 기준으로 감독 (SFT) 시 기존 최고 기준 대비 1.18~1.45배의 처리량 향상을 달성했습니다. 또한, 자기회귀 모델을 BDLMs로 변환하는 경우에도 1.27~1.33배의 성능 개선을 보였으며, 이 과정에서 최대 사용량을 유지하거나 감소시켰습니다.
이 기술은 대규모 컨텍스트에서도 높은 확장성을 입증했습니다. 8개의 H100 GPU 환경에서는 DFlash2 추론 학습 시 512K 컨텍스트 대비 2.48배, 1M 컨텍스트에서는 7.59배의 가속도를 달성했습니다. 또한, SWE-bench Verified 및 Terminal-Bench Lite와 같은 테스트에서 매칭된 조건으로 진행한 실험을 통해 모든 학습 체크포인트에서 더 높은 패스율을 기록했다고 보고합니다.
용어 풀이
- GPU
- 많은 계산을 한꺼번에 처리하는 칩. AI 학습과 실행에 가장 많이 써요.
- 미세 조정
- 이미 학습된 모델을 특정 목적의 데이터로 조금 더 학습시키는 일.
- HBM
- 메모리 칩을 쌓아 GPU에 데이터를 아주 빠르게 공급하는 메모리. AI 가속기에 들어가요.