리만 기하학 기반 ViT와 SSM의 하이브리드 모델 융합 연구
Riemannian--Lorentz Fusion of Vision Transformers and State-Space Models
 arXiv
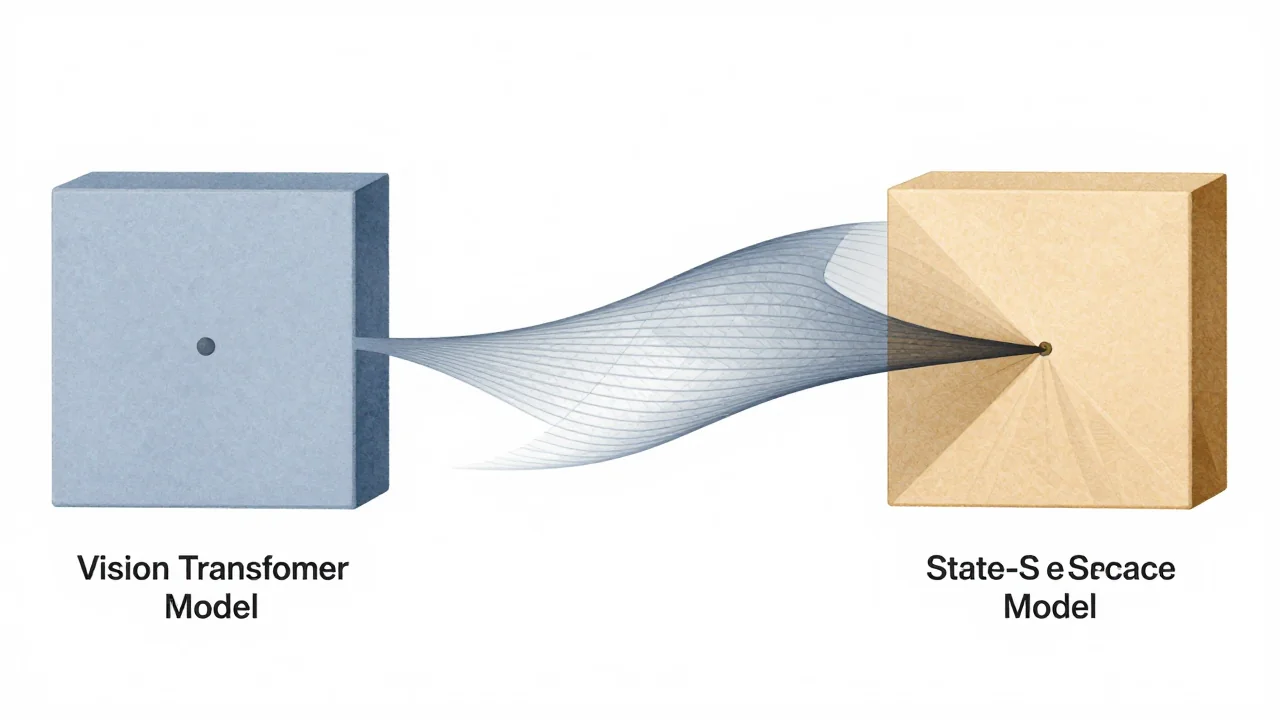
Vision Transformer(ViT)와 State-Space Model(SSM)처럼 구조가 다른 아키텍처의 모델들을 결합하는 어려움을 해결하기 위해 'Riemannian--Lorentz Parameter Fusion (RLPF)'라는 하이브리드 융합 방법을 제안했습니다.
- RLPF는 단순 가중치 합산이 아닌, 파라미터의 '의미적 역할'을 기준으로 그룹화하고 비유클리드 기하학(로렌츠 하이퍼볼로이드)을 활용하여 최적의 결합 지점을 찾아내는 것이 핵심입니다.
- 데이터 고갈과 막대한 학습 비용 문제가 심각한 현 AI 시장에서, 서로 다른 최고 성능 모델들을 효율적으로 통합할 수 있는 기술적 돌파구를 제시했다는 점에서 의미가 큽니다.
- 다만, 이 방법은 단순히 사전 학습된 체크포인트를 합치는 '훈련 없는' 방식이 아니며, 게이트와 최종 모델 등 일부 구성 요소에 대한 추가적인 훈련 과정이 필요합니다.
딥러닝 분야에서 데이터 고갈과 막대한 학습 비용이 주요 병목 현상으로 지적되면서, 사전 학습된 여러 모델을 결합하는 방법론에 대한 연구가 진행되고 있다. 기존의 공간 병합 방식은 아키텍처와 형태가 일치해야 하는 한계가 있었다. 이에 본 논문에서는 Vision Transformer(ViT)와 State-Space Model(SSM)처럼 구조적 차이가 큰 두 모델을 결합하기 위해 'Riemannian--Lorentz Parameter Fusion (RLPF)'라는 하이브리드 융합 방법을 제안한다.
제안된 RLPF 방법은 단순히 가중치를 합치는 것이 아니라, 파라미터 그룹들을 '의미적 역할'에 따라 정렬하고 공통 좌표로 투영하는 과정을 거친다. 이후 선택된 좌표를 로렌츠 하이퍼볼로이드 모델의 쌍곡 공간으로 끌어올려 정규화된 지오데식 바리센터를 계산한다. 이 결과를 두 개의 브랜치로 디코드하고, 학습 가능한 게이트가 각 입력에 대한 로짓을 결합하는 방식으로 작동한다.
실험 결과, 된 시스템은 CIFAR-10에서 82.37%, Oxford-IIIT Pet에서 75.04%, ImageNet-1K에서 78.58%의 최고 정확도를 기록했다. 다만, 연구진은 RLPF가 게이트와 최종 모델이 학습되는 '두 브랜치 하이브리드' 방식이며, 사전 학습된 체크포인트를 단순히 합치는 '훈련 없는(training-free)' 단일 체크포인트 병합과는 다르다는 점을 강조한다.
용어 풀이
- 가중치
- 학습으로 정해진 모델 내부의 숫자 값. 내려받는 모델 파일의 본체예요.
- 파라미터
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.
- 파인튜닝
- 이미 학습된 모델을 특정 목적의 데이터로 조금 더 학습시키는 일.