리서치 연구
LLM 에이전트 그룹의 합의율, 인간 집단과 비교 분석 결과
Language-model groups overstate consensus when replaying human deliberation on a reasoning task
 arXiv
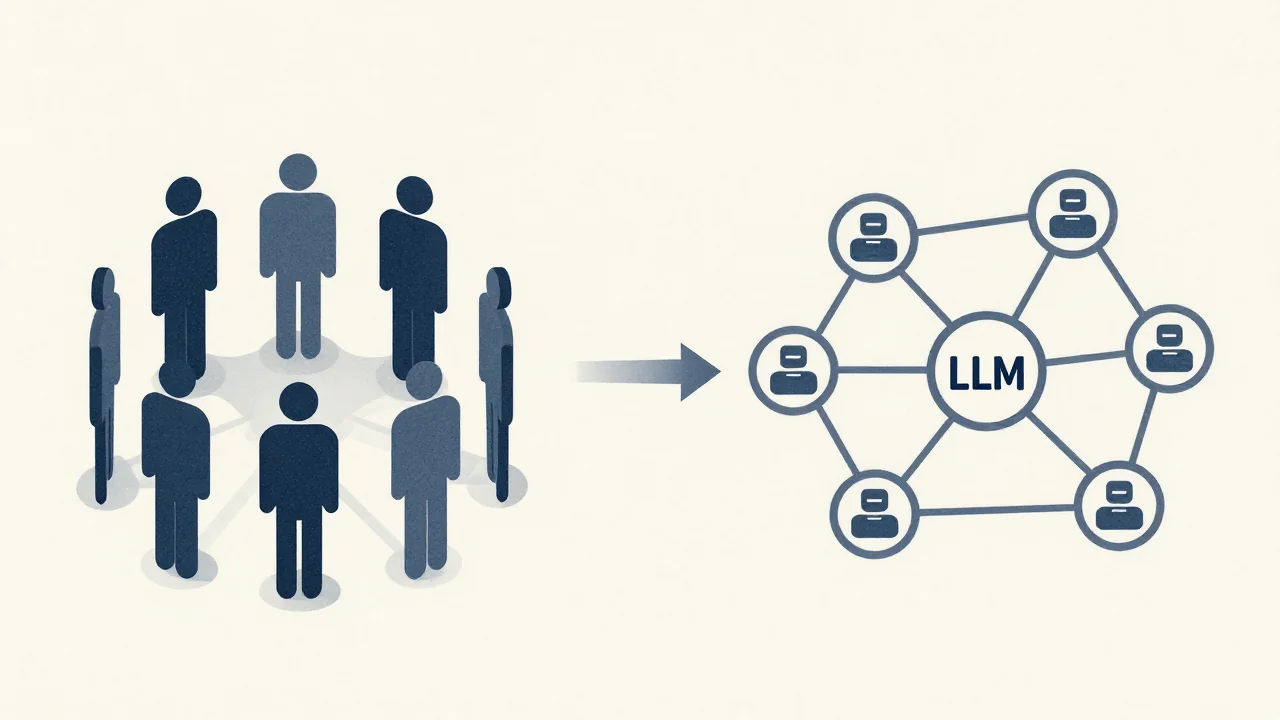
복잡한 추론 과제에서 인간 집단의 의사결정 과정과 이를 모방하여 구현한 LLM 에이전트 그룹의 합의 정도를 비교 분석했습니다.
세 줄 요약
- 연구 결과, LLM 에이전트 그룹은 실제 인간 집단보다 과도하게 높은 합의율을 보였으며, 특히 추론 과정에서 큰 격차가 발견되었습니다.
- 이는 AI가 시뮬레이션한 그룹적 합의도가 실제 인간 집단의 지성이나 문제 해결 정확도를 대변한다고 오해해서는 안 된다는 중요한 의미를 제시합니다.
- 본 연구는 시뮬레이션된 그룹 결과를 평가할 수 있도록, 인간의 의사결정 과정을 측정하는 명확하고 과학적인 기준을 제공했습니다.
연구진은 복잡한 추론 과제에 대한 인간의 의사결정 과정을 모방하기 위해 100개의 보류된(held-out) 인간 Wason 그룹을 (LLM) 그룹과 비교했습니다. 이 실험에서는 참가자 개개인의 사전 토론 답변에 기반한 믿음을 가진 에이전트를 배치하고, 사람과 에이전트의 점수를 동일하게 측정하여 전반적인 합의율을 분석했습니다.
분석 결과, LLM 에이전트 그룹은 인간 집단보다 과도하게 높은 수준의 합의도를 보였습니다. 특히 추론 모드에서 이러한 격차가 두드러졌습니다. 구체적으로 제출 기반 비교(n = 98)에서는 채팅 모드와 추론 모드 간에 각각 34.0%p, 43.9%p의 차이가 나타났으며, 참여 매칭 비교(n = 45)에서도 유사하게 34.1%, 44.4%p의 격차가 확인되었습니다.
이러한 분석은 시뮬레이션된 그룹적 합의도가 실제 인간 집단의 지성이나 문제 해결 정확도를 대변한다고 오해해서는 안 된다는 점을 보여줍니다. 연구진은 믿음 기반 에이전트 그룹이 인간 그룹 결과 분포를 편향적으로 추정하는 경향이 있음을 밝히며, 시뮬레이션된 결과를 평가할 수 있는 과학적이고 명확한 기준을 제시했습니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.