MILER: 비정형 자율주행을 위한 시뮬레이션-실제 전이 학습
MILER: Semantic Mid-Level Representation for Sim-to-Real Reinforcement Learning in Unstructured Autonomous Driving
 arXiv
자율주행의 난제인 시뮬레이션(Sim)과 실제 환경(Real) 간의 격차를 극복하는 새로운 정책 프레임워크 'MILER'를 제안했습니다.
- 단순히 출력을 직접 적용하는 대신, '궤적 정렬 전략'을 통해 인식 및 제어 모두를 시뮬레이션에서 실제 환경으로 전이시키는 것이 핵심입니다.
- 장애물, 급커브, 비포장 구간 등 다양한 난이도의 테스트 트랙에서 인간 개입 없이 총 17.3km를 주행하며 높은 실효성을 입증했습니다.
- 오프라인 학습 시 커스텀 '시맨틱 중간 레벨 표현(MLR)'을 사용하며, 전체 시스템은 Jetson AGX Orin 같은 임베디드 환경에서 구동됩니다.
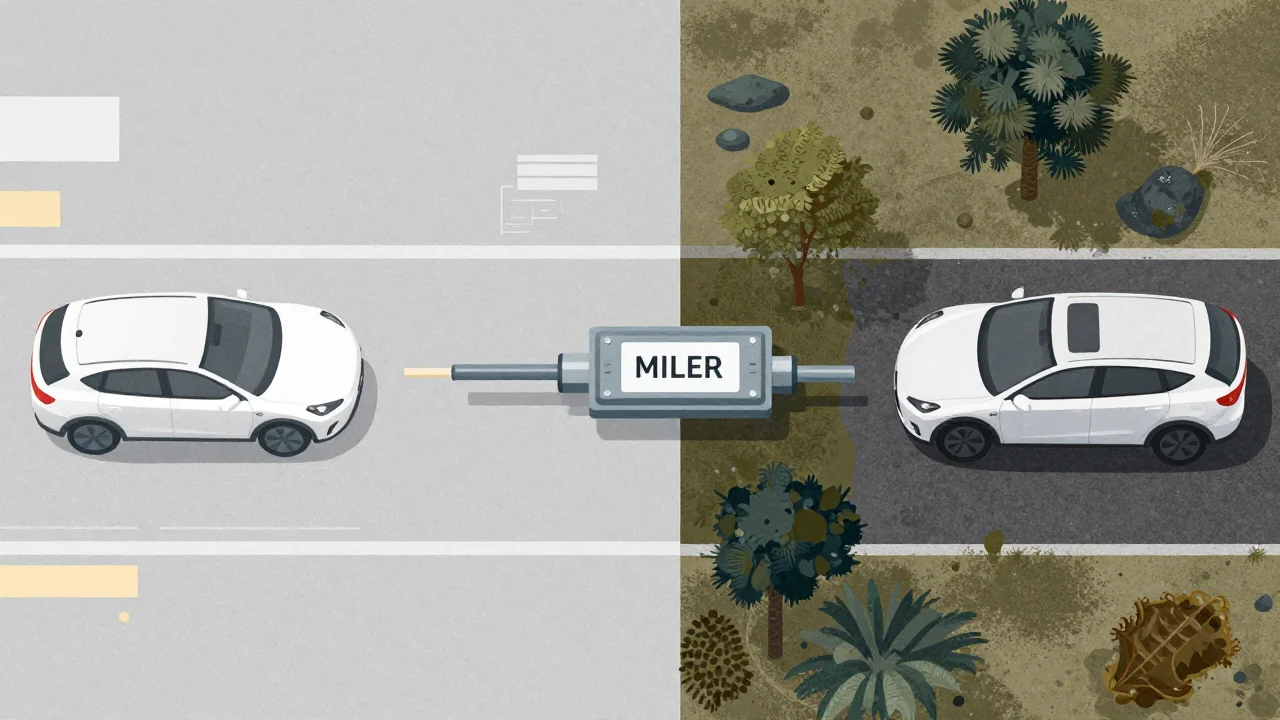
본 연구는 (Reinforcement Learning)의 잠재력을 활용하여 실제 환경에서의 자율주행 성능을 높이는 'MILER'라는 정책 프레임워크를 제안합니다. 특히 비정형 환경에서 발생하는 시뮬레이션-실제 전이(sim-to-real transfer) 문제를 해결하는 데 중점을 두었습니다. 오프라인 학습 과정에서는 커스텀한 시맨틱 중간 레벨 표현(MLR) 시뮬레이터를 사용하여 정책 네트워크를 훈련하며, 이 제어 출력은 자전거 모델에 직접 적용됩니다.
실제 차량 환경에서 배포할 때는 카메라 및 LiDAR 데이터를 BEVFusion을 통해 처리하여 MLR 시뮬레이터와 일치하는 의미론적 조감도(semantic bird's-eye-view) 표현을 생성합니다. 중요한 점은 정책 네트워크가 생성한 액션을 실제 차량에 직접 적용하지 않는다는 것입니다. 대신, 인식과 제어 모두를 시뮬레이션에서 실제 환경으로 전이시키는 '궤적 정렬 전략(trajectory-alignment strategy)'을 사용하여 전이를 구현했습니다.
제안된 프레임워크는 다양한 장애물, 급커브 구간, 최대 33.6 km/h의 속도, 오프로드 구역 등을 포함하는 테스트 트랙에서 광범위하게 평가되었습니다. 연구진은 총 3.0km 길이의 테스트 트랙을 두 대의 차량으로 인간 개입 없이 총 17.3km를 주행하며 접근 방식의 효과성을 입증했습니다. 이 전체 소프트웨어 스택은 Jetson AGX Orin과 같은 임베디드 환경에서 구동됩니다.
용어 풀이
- 강화학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.
- 제로샷
- 예시를 하나도 주지 않고 바로 과제를 시키는 방식.