TAPe+ML: 다중 작업 컴퓨터 비전을 위한 구조적 표현 학습
TAPe+ML: A Compact Structured Representation for Multi-Task Computer Vision
 arXiv
TAPe+ML v3는 이미지 분류, 객체 탐지 등 다중 작업을 수행하며, 원본 픽셀 대신 능동 지각 이론(TAPe) 기반의 구조화된 표현을 활용하는 시스템입니다.
- 파라미터 수가 10만 개 미만으로 매우 작음에도 불구하고, COCO 객체 탐지 및 인스턴스 분할 등에서 높은 성능을 달성하며 효율성을 입증했습니다.
- 모델 학습의 부담을 복잡한 신경망 파라미터가 아닌 구조화된 입력 표현에 분산시켜, 자원이 제한적인 환경에서도 고성능 비전 시스템 구축이 가능합니다.
- 시스템 성능이 '구조화된 입력 표현'에 크게 의존하므로, 이 방식이 모든 종류의 비전 문제에 완벽하게 적용되는지는 추가 검증이 필요할 수 있습니다.
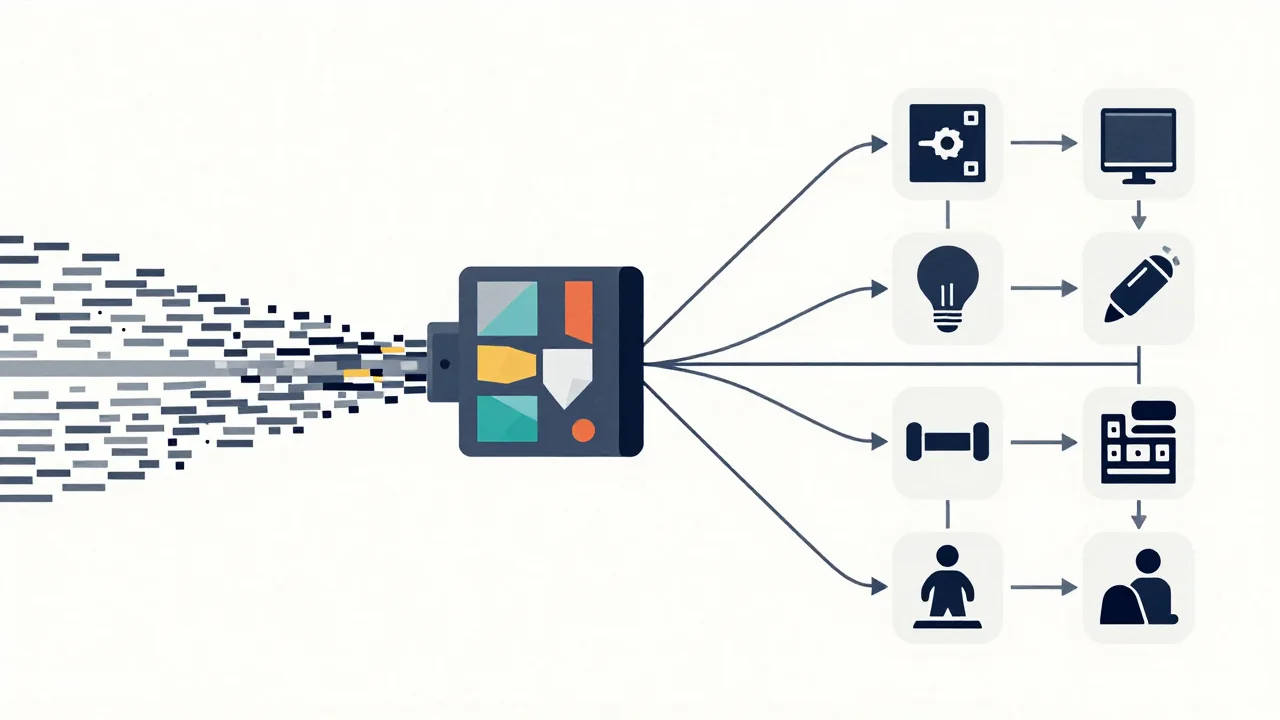
연구진은 능동 지각 이론(Theory of Active Perception, TAPe)을 기반으로 하는 소형 컴퓨터 비전 시스템인 TAPe+ML v3를 제시했습니다. 이 시스템은 이미지 분류, 객체 탐지, 인스턴스 분할 등 다중 작업을 수행하며, 원본 픽셀 텐서에 직접 작동하는 대신 공유된 TAPe 표현과 모듈식 인식 아키텍처를 활용합니다.
TAPe+ML v3는 배경 및 윤곽 처리, 국소 객체 위치 파악, 프로토타입 기반 분류, 그리고 전문 서브 모델을 조정하는 코디네이터로 구성되어 있습니다. 이 시스템은 전체 실험에서 10만 개 미만의 를 사용하며, 구조화된 입력 표현에 일부 모델링 부담을 분산시키는 것이 데이터, 메모리, 컴퓨팅 자원 요구 사항을 줄인 컴팩트한 다중 작업 비전 시스템을 지원함을 보여줍니다.
실험 결과, COCO 객체 탐지에서 84.7 mAP50 및 65.3 mAP50-95를 달성했으며, COCO 인스턴스 분할에서는 80.7 mask mAP50과 58.4 mask mAP50-95의 성능을 기록했습니다. 또한 분류 실험에서 Imagenette에 대해 92%의 검증 정확도를 보였으며, ImageNet-Real에서는 Top-1 정확도 89.9%를 달성하는 등 높은 효율성을 입증했습니다.
용어 풀이
- 파라미터
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.