모델 연구
Elastic Threshold Attention: Learned Contextual Sparsity for Long-Context Decoding
 arXiv
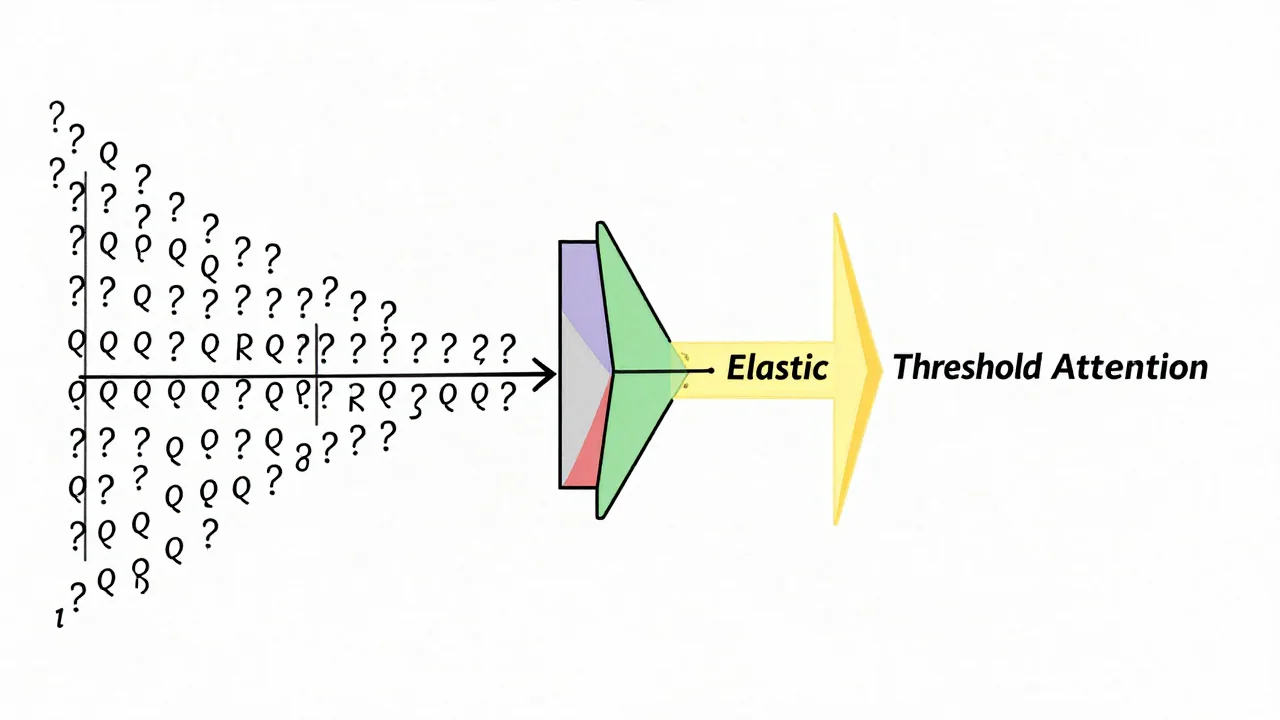
긴 문맥 처리 시 발생하는 메모리 대역폭 병목 현상을 해결하기 위해 'Elastic Threshold Attention(ETA)'가 개발되었습니다. 이 아키텍처는 쿼리 표현으로부터 동적인 임계값을 예측하여 필요한 정보만 집중적으로 계산합니다.
세 줄 요약
- ETA는 쿼리 기반의 동적 임계값 예측을 통해 불필요한 토큰은 제거하고, 어려운 추론 단계에는 밀집 모델 수준의 높은 집중도를 유지하는 것이 핵심입니다.
- 최대 512K 토큰까지 처리 가능한 초장문맥 환경에서, 기존 대비 최대 2.5배에 달하는 추론 속도 향상을 제공하여 대규모 언어 모델의 실용성을 극대화합니다.
- 훈련 과정에서 정보 손실 없이 높은 희소성(최대 85%)을 학습하며, 도메인별 배포 시 오프라인 보정 알고리즘으로 계산량을 추가 절감할 수 있습니다.
긴 문맥 처리 시 발생하는 메모리 대역폭 병목 현상을 해결하기 위해 'Elastic Threshold Attention(ETA)'가 개발되었습니다. 이 아키텍처는 쿼리 표현으로부터 동적인 임계값을 예측하여 필요한 정보만 집중적으로 계산합니다.