안전성 제약 조건을 만족하는 베이즈 적응 강화학습 연구
Efficient Bayes-Adaptive Reinforcement Learning with Temporal Logic Specifications
 arXiv
안전성이나 도달 가능성과 같은 복잡한 제약 조건(LTL)을 만족시키면서 정책을 학습하는 새로운 모델 기반 강화학습 알고리즘을 개발했습니다.
- 환경을 베이즈 적응 마르코프 결정 과정(BAMDP)으로 모델링하고, 이를 통해 개선된 탐험-활용 균형과 몬테카를로 계획 알고리즘을 도입했습니다.
- 기존의 비베이즈 방식 대비 제약 조건 만족도와 샘플 효율성을 크게 높여, 실제 위험 환경에서의 AI 적용 가능성을 입증했습니다.
- 본 방법은 근사적인 최적 전략 합성을 목표로 하며, 특히 정책 학습 중 발생하는 임무 위반을 줄이는 '신중한(Cautious) RL' 분야에 성공적으로 활용됩니다.
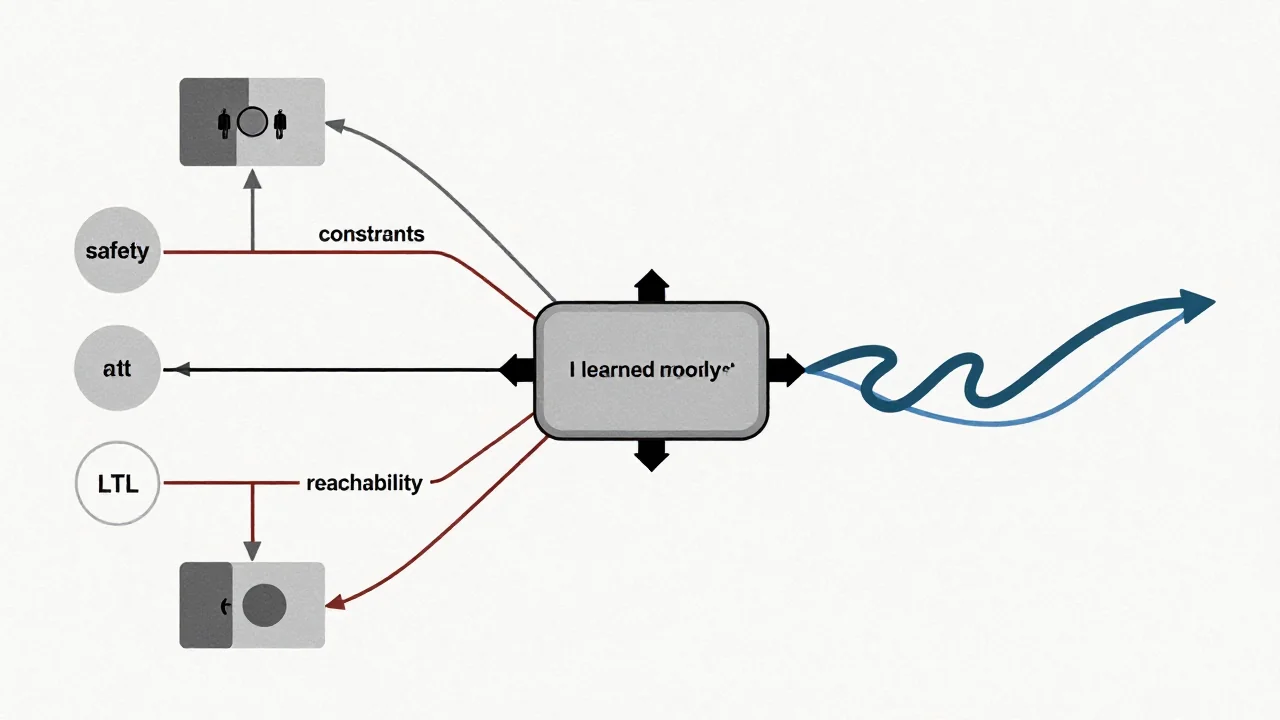
본 연구는 주어진 선형 시간 논리(LTL) 사양(예: 안전성 또는 도달 가능성) 하에서 효율적인 정책 합성을 위한 새로운 모델 기반 알고리즘을 제시합니다. 이를 위해 LTL 작업을 나타내는 Limit-Deterministic Büchi Automaton (LDBA) 표현과 환경의 Bayes-Adaptive Markov Decision Process (BAMDP) 표현을 동기화하여 사용했습니다.
이러한 동기화는 전통적인 비베이즈 접근 방식과는 달리 베이지안 RL을 활용하여 개선된 탐험-활용 균형을 확보하는 것이 특징입니다. 연구진은 나아가 동기화된 BAMDP 구조 내에서 근사적인 베이즈 최적 전략 합성을 수행할 수 있도록 새로운 Bayes-Adaptive Monte-Carlo Planning (BAMCP) 알고리즘을 제안했습니다.
다양한 유한 및 무한 지평 과제 실험 결과, 본 접근 방식은 전통적인 모델 프리 방법론 대비 속성 만족도와 샘플 효율성 측면에서 효과적임이 입증되었습니다. 특히 추가 연구를 통해 새로운 BAMCP 알고리즘이 LTL 작업 만족도에 기여하는 가치가 확인되었으며, 정책 학습 중 발생하는 임무 위반을 줄이는 '신중한(Cautious) RL' 분야에도 성공적으로 적용되었습니다.
용어 풀이
- 강화학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.