파편화된 예술 작품 스타일 분류를 위한 비전 트랜스포머 연구
Fragment-Aware Vision Transformers for Fresco-Fragment Style Classification
 arXiv
예술 작품이 파편화된 고고학적 환경에서 스타일을 분류하는 것은, 전체 구성을 활용하던 기존의 분석 방식으로는 큰 한계가 있습니다.
- 연구진은 전경 가이드 마스킹과 인페인팅 기반 정규화 기법을 도입하고 대비 학습 목표를 추가한 트랜스포머 모델을 개발했습니다.
- 이 모델은 높은 인식률 향상을 입증했을 뿐만 아니라, AI가 실제로 원본의 칠해진 증거를 활용했는지 해석적으로 검증했다는 점에서 의미가 큽니다.
- 복잡한 구조를 추가하더라도 단순 조합(앙상블) 방식과 성능 차이가 크지 않으므로, 모델 설계 시 과도하게 복잡한 구조는 지양할 필요가 있습니다.
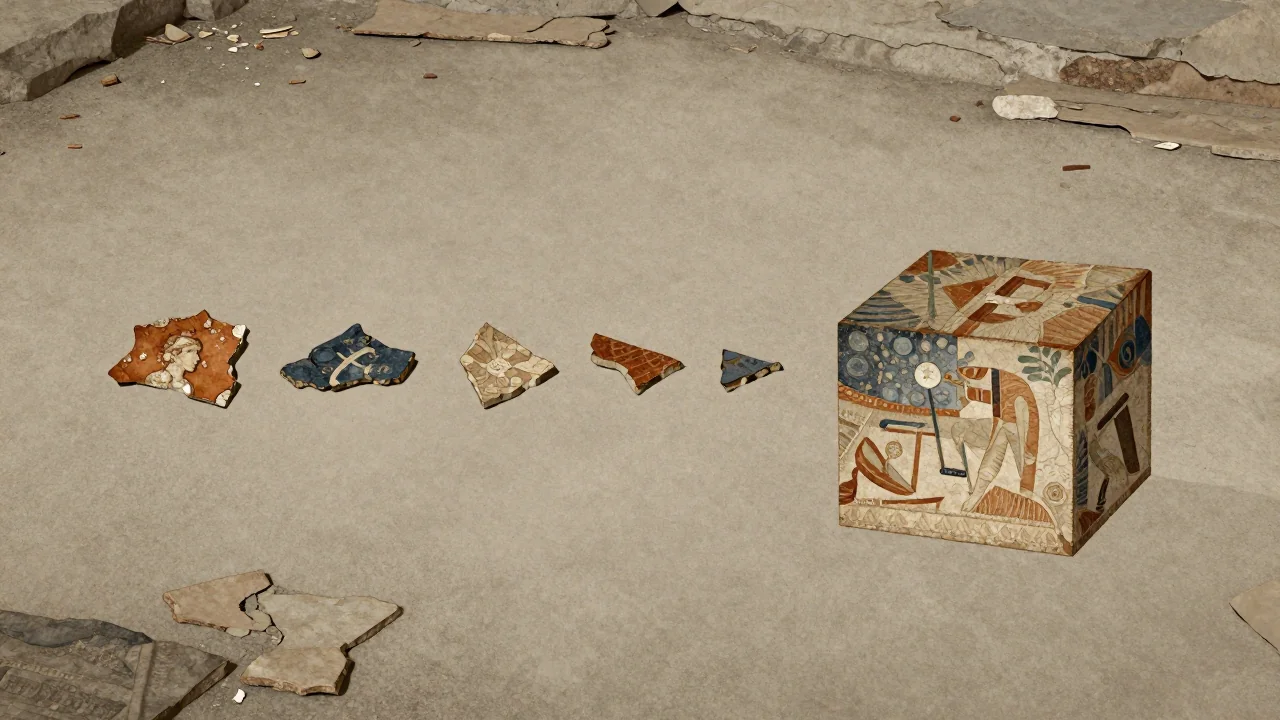
기존의 예술 스타일 분류 모델은 일반적으로 전체적인 구성을 활용하는 완전한 작품을 전제로 합니다. 그러나 고고학적 환경에서 발견되는 작품들은 종종 파편화되어 있어, 불완전하고 맥락이 제한된 시각적 증거를 기반으로 인식을 수행해야 하는 어려움이 있습니다. 연구진은 이러한 문제를 해결하기 위해 점진적인 기반 프레임워크를 개발했습니다. 이 모델은 배경만 포함하는 을 억제하는 포그라운드 가이드 마스킹과, 불규칙한 파편 지지대를 ViT 패치 그리드에 맞추는 인페인팅 기반 기하학적 정규화를 도입합니다.
모델의 성능 향상을 위해 지도 대비 목표(supervised contrastive objective)가 추가되었으며, 이는 Kullback-Leibler 유사도를 통해 예측 분포에 작동합니다. CLEOPATRA 데이터셋에서 실험 결과, 이 앙상블 방식은 기존 ViT 기준선보다 정확도를 0.604에서 0.656으로 높였고, macro-F1 점수 역시 0.596에서 0.648로 향상시키는 결과를 보였습니다.
이 연구는 단순히 성능 개선에 그치지 않고, 모델이 실제로 원본의 칠해진 증거를 활용하는지 해석적 분석을 통해 검증했다는 점에서 의미가 있습니다. 또한 복잡한 그래프-융합 변형(graph-fusion variant)을 평가했을 때도 단순 학습 가능한 로짓 앙상블 방식과 성능 차이가 크지 않아, 모델 설계 시 과도하게 복잡한 구조를 지양할 필요가 있음을 확인했습니다.
용어 풀이
- 트랜스포머
- 오늘날 대부분의 언어 모델이 쓰는 신경망 구조. 문장 속 단어들의 관계를 한꺼번에 계산해요.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.