반복적 행동 개선을 통한 연속 제어 정책 학습: REFINEPPO
REFINEPPO: Learning Continuous Control Policies by Iterative Action Refinement
 arXiv
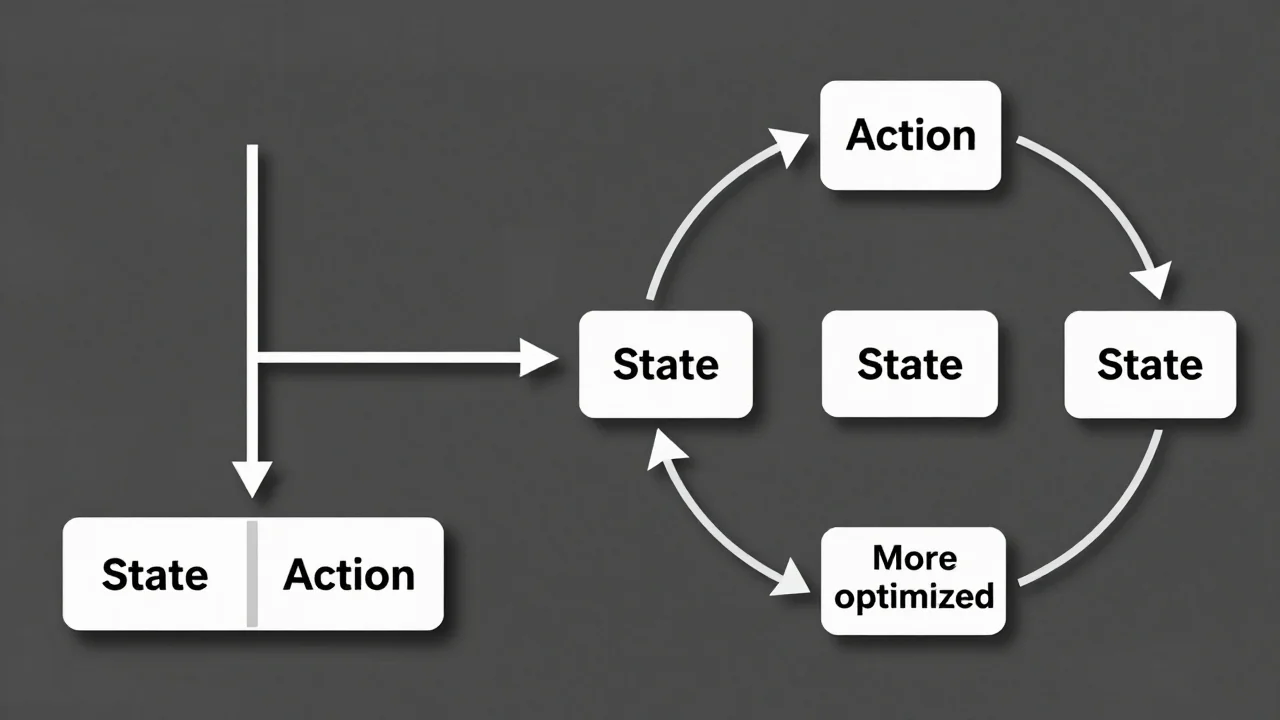
기존의 행동 예측 방식은 상태를 보고 액션을 한 번에 결정하는 단방향 구조였으나, REFINEPPO는 액션 자체를 반복적으로 개선하며 학습하는 새로운 방식을 도입했습니다.
- 이 모델은 초기 제안된 행동을 시작으로, 현재 상태와 이전 단계의 예측값을 기반으로 잔여 보정(residual corrections)을 거쳐 최종 액션을 점진적으로 완성합니다.
- 행동 결정 과정에 '반복적 개선' 단계를 추가함으로써, 정책이 단순 추측을 넘어 여러 번 검토를 통해 최적화된 결정을 내리게 되어 학습 효율성이 크게 향상됩니다.
- 총 14가지 벤치마크 과제에서 표준 PPO와 동등하거나 그 이상의 성능을 입증했으며, 다양한 분석(ablation studies)으로 방법론의 효과를 다각도로 검증했습니다.
기존의 심층 (DRL) 기반 연속 제어 정책들은 일반적으로 관찰된 상태를 액션 또는 액션 분포로 직접 매핑하는 단방향 구조를 가집니다. 이러한 방식은 최적의 제어 결정을 한 번에 내리는 데 효과적이지만, 초기 예측이 형성된 후 정책이 행동을 재고하거나 점진적으로 개선할 기회가 적다는 한계가 있습니다.
본 연구에서는 액션을 직접 예측하는 대신, '반복적 행동 정제(Iterative Action Refinement, IAR)'라는 새로운 방법을 제안합니다. 이 방법은 초기 제안값에서 시작하여, 공유된 정제 네트워크가 관찰 상태와 현재의 행동 제안값을 반복적으로 조건화하며 학습된 잔여 보정(residual corrections)을 통해 제어 액션을 구성합니다. 각 정제 단계는 이전 단계를 거쳐 만들어진 액션에 기반하여 수정됩니다.
이러한 반복적 행동 구축 메커니즘은 근접 정책 최적화(PPO)와 통합되어 REFINEPPO를 구현했습니다. 연구팀은 14가지 제어 과제에서 REFINEPPO의 성능을 평가했으며, 표준 PPO와 동등하거나 그 이상의 성능을 보였습니다. 또한 여러 과제에서 더 빠른 수렴 속도를 입증하며 반복적 정제의 효과를 검증했습니다.
용어 풀이
- 강화 학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.