TinyCeNN-LM: 품질 게이트 기반 LLM 어텐션 변환 기술
TinyCeNN-LM: Quality-Gated Conversion of Pretrained Attention with CeNN-Inspired Cellular-Recurrent Layers
 arXiv
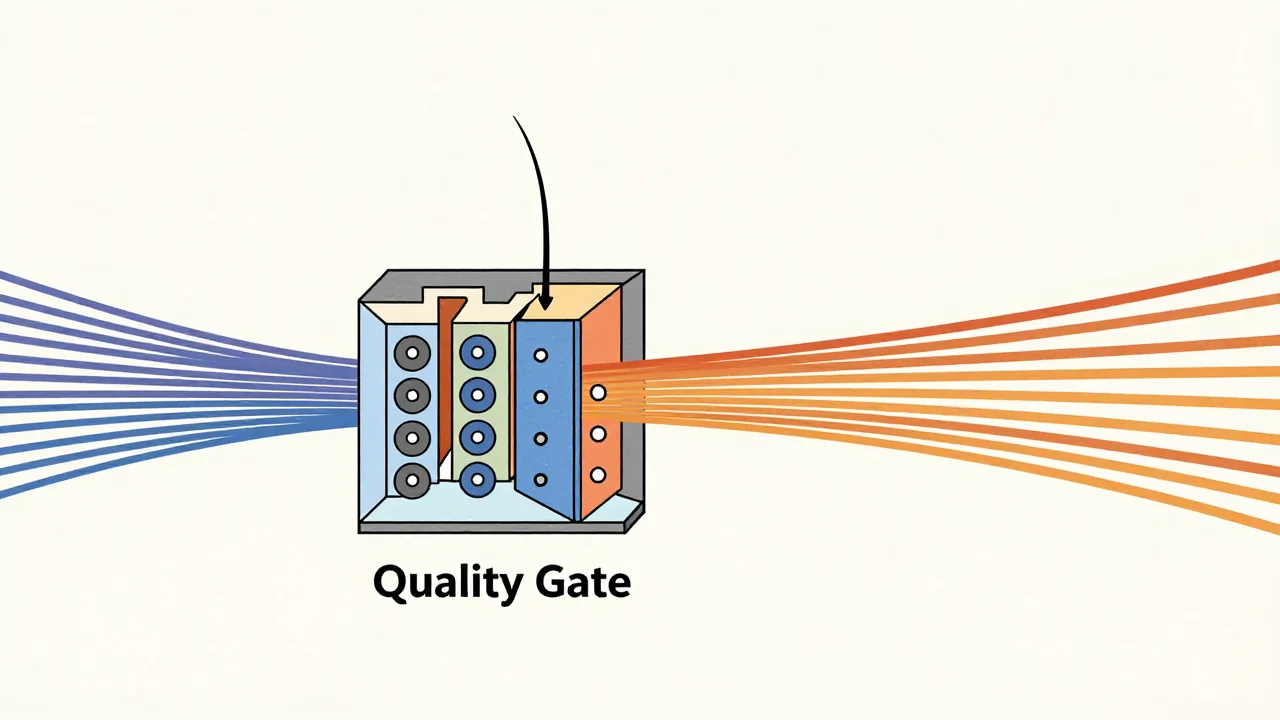
기존 LLM의 어텐션 대체는 표현력 손실 위험이 커서 어려웠습니다. TinyCeNN-LM은 CeNN 기반 셀룰러-순환 레이어를 활용한 '품질 게이트' 변환 프레임워크를 제시합니다.
- 이 방법론은 모델 성능 저하 없이 구조적 변환을 성공적으로 수행하며, 메모리 사용량을 최대 6%까지 줄이는 높은 효율성을 입증했습니다.
- 이는 대규모 언어 모델(LLM)의 경량화 및 배포 과정에서 발생하는 크기/속도 문제를 해결하는 중요한 기술적 돌파구를 제공합니다.
- 변환은 무조건적인 대체가 아닌, 표현력과 통계적 기준을 모두 만족하는 레이어만 선별적으로 적용해야 한다는 점에 유의해야 합니다.
사전 학습된 언어 모델()에서 어텐션을 대체하는 것은 호환성 문제가 따릅니다. 임의로 대체할 경우 후속 레이어가 기대하는 표현력이 변경될 수 있기 때문입니다. TinyCeNN-LM은 이러한 문제를 해결하기 위해 CeNN 기반 셀룰러-순환 레이어를 활용한 '품질 게이트(quality-gated) 사후 학습 변환' 프레임워크를 제시합니다. 이 방법론은 경계가 있는 로컬 처리, 압축된 순환 메모리, 라우팅, 융합 및 수락/롤백 검증을 포함합니다.
이 프레임워크는 엄격한 PDelta3 변환 과정을 통해 레이어가 표현력과 NLL 기준을 모두 통과할 때만 적용됩니다. SmolLM2-135M 모델에서는 레이어 0~2가 수락되었으며 누적 $\Delta\mathrm{NLL}$은 $+0.01209$를 기록했습니다. 반면, 레이어 3은 NLL 기준을 통과했음에도 표현력 충실도가 실패하여 거부되었습니다. Qwen3.5-0.8B 모델에서는 전체 어텐션 레이어 중 3, 7, 11이 수락되었고 최종 $\Delta\mathrm{NLL}$은 $+0.02073$을 기록했습니다.
Integrated Memory 구현 시 퍼플렉시티는 $-0.07\%$에서 $+0.93\%$ 사이를 유지하면서 전체 캐시 사용량을 최대 $6.01\%$까지 줄이는 효율성을 보였습니다. 또한, 샘플링된 200개 항목의 다운스트림 테스트에서는 변환된 Qwen 모델이 $28.5\%$에서 $32.0\%$ 사이의 전반적인 정확도를 나타냈습니다. 이러한 결과는 범용적인 어텐션 대체나 속도 향상보다는 보수적이고 품질 게이트가 적용된 구조적 변환이 유효함을 뒷받침합니다.
용어 풀이
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.