멀티모달 콘텐츠 검열을 위한 분리형 이해 및 정책 학습 모델
Summarize, Judge, Refine: Decoupled Content Understanding and Policy Learning for Multimodal Content Moderation
 arXiv
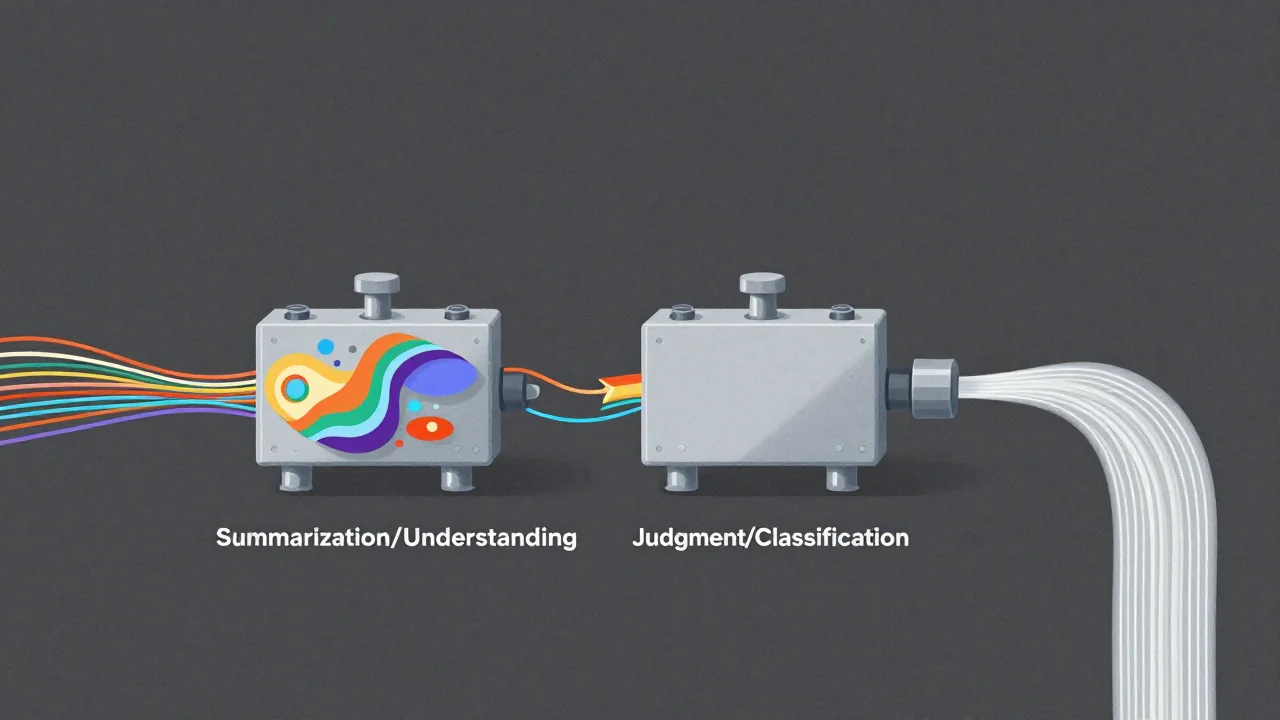
기존 멀티모달 콘텐츠 검열 시스템의 한계를 극복하기 위해, '요약-판단-정제(SJR)'라는 2개 모델 아키텍처를 제안했습니다. 이는 복잡한 이해 과정과 정책 분류 과정을 분리하여 작동하는 것이 핵심입니다.
- 이 방식은 원본 미디어를 구조화된 텍스트 요약으로 변환하고, 이를 통해 실제 위반 사례가 없어도 새로운 정책을 적용할 수 있는 '제로샷 학습' 능력을 입증했습니다.
- 모든 검열 결정의 근거를 사람이 읽기 쉬운 요약문 형태로 제공하여 시스템 투명성을 높였으며, 정책 변경 시 전체 모델 재학습 부담을 크게 줄였습니다.
- 특히 원본 데이터가 아닌 텍스트 공간에서만 가능한 증강(augmentation) 기법을 활용해 정책 학습 효율성을 극대화한 점이 이 기술의 가장 큰 강점입니다.
기존의 콘텐츠 검열 시스템은 복합적인 이해 과정과 특정 정책 분류가 결합되어 있어, 정책이 변경될 때마다 전체 파이프라인을 재학습해야 하는 한계가 있었습니다. 본 연구에서는 이러한 문제를 해결하기 위해 '요약-판단-정제(SJR)'라는 2개 모델 아키텍처를 제안했습니다. 이 방식은 멀티모달 이해와 정책 분류의 책임을 분리하여, 자연어 인터페이스를 통해 작동하는 것이 핵심입니다.
SJR 구조에서 다중 모드 콘텐츠 모델이 구조화된 텍스트 요약문을 생성하고, 별도의 텍스트 전용 정책 모델(Policy Model)이 이 요약문들을 정책 정의에 따라 분류합니다. 시스템은 GRPO를 이용한 반복적인 공동 학습 루프를 통해 콘텐츠 모델을 정제하며, 원본 미디어에서는 불가능한 텍스트 공간 증강 기법을 활용하여 적대적 요약 변형(adversarial summary variants)을 생성함으로써 소수 예시만으로 정책을 학습할 수 있게 합니다.
이 아키텍처는 모든 결정의 근거를 사람이 읽기 쉬운 요약문 형태로 제공하여 해석 가능성(interpretability)을 구조적인 부산물로 확보합니다. 실제 위반 사례가 없는 경우에도 새로운 정책 적용이 가능하며, 특히 오해의 소지가 있는 광고 탐지 실험에서 SJR은 체인-오브-쏘트 기준선 대비 +23.6%의 상대적 비위반 F1 점수를 달성했습니다.
더 나아가, 실제 위반 사례 데이터가 전혀 없는 경우에도 새로운 정책을 시작할 수 있음을 입증했습니다. 합성적으로 생성된 긍정 클래스 데이터를 사용한 변형 모델은 전체 데이터 모델과 비교했을 때 위반 F1에서 0.2%의 상대적 오차를 보이며 일치하는 성능을 나타냈습니다.
용어 풀이
- 멀티모달
- 글뿐 아니라 이미지·음성·영상처럼 여러 형태의 입력을 함께 다루는 것.
- 제로샷
- 예시를 하나도 주지 않고 바로 과제를 시키는 방식.