확산형 LLM의 학습 데이터 탐지 효율화 방안
Weak Ties, Strong Signals: Efficient Training Data Detection in Diffusion LLMs via Independent Token Sampling
 arXiv
확산형 LLM(dLLM)의 민감 데이터 노출 위험에 대응하기 위해, 토큰 간 의존성 문제를 해결한 '독립 토큰 샘플링(ITS)' 프레임워크가 개발되었습니다.
- 기존 방식이 놓치던 마스킹된 토큰 간 복잡한 의존성을 ITS는 주의 집중 기반 근사치를 활용해 정확하게 포착하며 효율성을 높였습니다.
- AI 모델의 데이터 프라이버시 및 보안 중요성이 커지면서, dLLM이 학습 데이터를 얼마나 기억하는지 객관적으로 진단할 기술적 기준 마련이 필수적입니다.
- ITS는 제한된 쿼리 예산에서도 뛰어난 성능을 유지하며, 토큰 다양성 전략으로 데이터 유출 탐지 신뢰도를 크게 향상시킨 것이 특징입니다.
Diffusion Large Language Models(dLLMs)는 기존의 자기회귀 모델에 대안을 제시하지만, 디노이징 과정에서 민감한 학습 데이터를 노출할 위험이 있습니다. dLLM은 인과적 아키텍처가 가진 효율적인 단일 통과 확률 분해 능력이 부족하여 이러한 데이터 사용 여부를 감지하기 어렵습니다. 기존의 방법들은 무작위 마스킹에 의존하지만, 이 방식은 마스킹된 간의 종속성을 제어하지 못하며, 이는 누적 조건부 상호 정보량(CMI)으로 이론화되는 비음 구조 추정 오차를 발생시켜 미묘한 암기 신호를 가릴 수 있습니다.
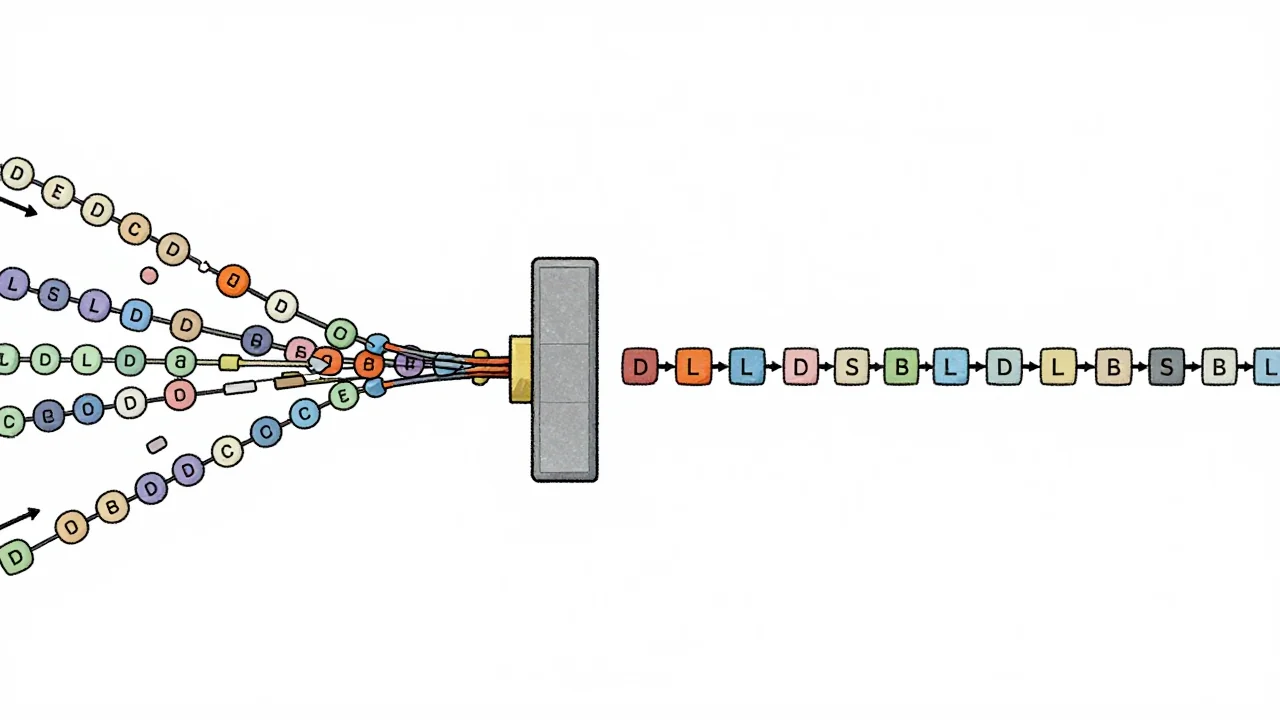
이러한 문제를 해결하기 위해 연구진은 독립 토큰 샘플링(Independent Token Sampling, ITS)이라는 쿼리 효율적인 프레임워크를 제안했습니다. ITS는 주의 집중 기반의 쌍별 종속성 근사치(pairwise dependency proxy)를 활용하여 CMI 인식 선택 기준을 근사합니다. 또한, ITS는 샘플링 라운드 전반에 걸쳐 토큰 커버리지를 개선하는 다양성 증진 전략을 통합하여, 종속성으로 인한 근사 오차의 영향을 줄인 집계된 토큰별 신호를 얻게 합니다.
실험 결과에 따르면, ITS는 다양한 모델과 데이터셋에서 최신 기술(state-of-the-art) 기반 방법들을 일관되게 능가하는 성능을 보였습니다. 특히 ArXiv 데이터셋에서는 AUC를 0.18 개선하는 성과를 달성했으며, 제한된 쿼리 예산 하에서도 강력한 성능을 유지함을 입증했습니다.
용어 풀이
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.